ADK 的 BigQuery 智能体分析插件
BigQuery 智能体分析插件通过为深入的智能体行为分析提供强大的解决方案,显著增强了智能体开发套件(ADK)。它利用 ADK 插件架构和 BigQuery Storage Write API,直接将关键操作事件捕获并记录到 Google BigQuery 表中,为你提供高级调试、实时监控和全面离线性能评估的能力。
该插件还提供了自动模式升级(安全地向现有表添加新列)、工具来源追踪(LOCAL、MCP、SUB_AGENT、A2A、TRANSFER_AGENT、TRANSFER_A2A)、用于人工参与交互的 HITL 事件追踪,以及自动视图创建(生成扁平化、便于查询的事件视图)。
ADK 2.0 多智能体工作流支持将追踪扩展到智能体传输、状态检查点、事件压缩和长时间运行的工具。它增加了四种新的事件类型:AGENT_TRANSFER、AGENT_STATE_CHECKPOINT、EVENT_COMPACTION 和 TOOL_PAUSED。它还在每一行上标记一个 attributes.adk 信封,以便你可以重建智能体执行图并将暂停的工具与恢复它的行关联起来。在 Java 中,此支持目前仅涵盖 TOOL_PAUSED 事件及其暂停/恢复配对键(不包含 attributes.adk 信封)。详情请参见智能体工作流和暂停/恢复事件 (ADK 2.0)。
该插件包含三项可靠性和可观测性修复(Java:v1.7.0 或更高版本):
- 跨区域 Storage Write API 路由。 对
US多区域之外的 BigQuery 数据集(例如EU或northamerica-northeast1)的写入现在会路由到拥有写入流的区域。之前它们可能会因 "session not found" / stream-not-found 错误而失败,并静默丢弃每一行。 - 交付和内容事件可观测性。 交付损失按原因追踪。Python 还会统计写入了哨兵行的格式化器和解析器失败。计数器通过
BigQueryAgentAnalyticsPlugin.get_drop_stats()(Python)或getDropStats()(Java)暴露,因此宿主可以轮询并将其导出到自己的监控系统。原因键和语义因语言而异;请参见丢弃事件可观测性。 - Cloud Trace 中无重复 span。 当 Agent Engine 遥测(
GOOGLE_CLOUD_AGENT_ENGINE_ENABLE_TELEMETRY=true)或任何其他 Cloud Trace 导出器连接到全局 tracer 提供者时,插件不再在每个框架 span 旁边产生重复的 span。插件仍然从环境 OTel span 继承trace_id,因此 BigQuery 行继续干净地关联到 Cloud Trace 追踪。
在 Python v2.7.0 及更高版本中,每一行在进入写入队列之前都会收到一个稳定的 event_id。该 ID 在 Storage Write API 重试时保持不变,因此消费者可以识别重试重复项。可选的 exactly_once_delivery 模式使用已提交流和显式偏移量来防止实时处理器中因模糊重试导致的重复。此模式不保证无损交付;请参见交付和去重。
同一 Python 版本还添加了模型和工作流终止详情。最终的 LLM_RESPONSE 行包含 finish_reason,以及在模型提供时包含清理后的 error_message。工作流节点可以发出 NODE_OUTPUT 和 NODE_ERROR,未处理的智能体或运行异常则发出 AGENT_ERROR 和 INVOCATION_ERROR。
BigQuery Storage Write API
此功能使用 BigQuery Storage Write API,这是一项付费服务。 有关费用信息,请参阅 BigQuery 文档。
Kotlin 支持
Kotlin 插件会记录调用生命周期事件。当调用开始时写入一行 INVOCATION_STARTING,结束时写入一行 INVOCATION_COMPLETED,并在首次使用时创建分区、聚簇的事件表(如果尚不存在)。
行是通过 tabledata.insertAll 逐行插入的,在调用路径上同步执行,而不是通过 Python 和 Java 使用的 Storage Write API。
Kotlin 中未实现以下功能:LLM、工具、智能体、状态、HITL 和 A2A 事件;ADK 2.0 工作流事件;自动视图创建;自动 Schema 升级;工具来源追踪;GCS 卸载;以及丢弃统计。
使用场景
- 智能体工作流调试与分析:将广泛的插件生命周期事件(LLM 调用、工具使用)和智能体产出事件(用户输入、模型响应)捕获到定义良好的模式中。
- 高量分析与调试:使用 Storage Write API 异步执行日志记录操作,以实现高吞吐量和低延迟。
- 多模态分析:记录和分析文本、图像及其他模态。大文件会卸载到 GCS,通过对象表可供 BigQuery ML 访问。
- 分布式追踪:内置对 OpenTelemetry 风格追踪(
trace_id、span_id)的支持,以可视化智能体执行流。 - 工具来源追踪:追踪每次工具调用的来源(本地函数、MCP 服务器、子智能体、A2A 远程智能体或传输智能体)。
- 智能体工作流追踪 (ADK 2.0):捕获智能体传输、状态检查点、事件压缩和长时间运行的工具暂停/恢复,并通过
attributes.adk信封重建执行图。 - 可查询事件视图:自动创建扁平化、按事件类型划分的 BigQuery 视图(例如
v_llm_request、v_tool_completed),通过展开 JSON 负载数据来简化下游分析。
捕获事件摘要
下表列出了插件记录的所有事件类型。有关详细的负载示例,请参见事件类型和负载。View 列显示可选的 BigQuery 视图。Python 默认创建视图;Java 仅在配置了 createViews(true) 时创建。
在 Kotlin 中,插件仅记录 INVOCATION_STARTING 和 INVOCATION_COMPLETED,不创建视图,因此其他行和整个 View 列适用于 Python 和 Java。
该表是 Python 和 Java 事件集的并集。INVOCATION_ERROR、AGENT_ERROR、AGENT_TRANSFER、AGENT_STATE_CHECKPOINT、EVENT_COMPACTION、NODE_OUTPUT 和 NODE_ERROR 仅限 Python。Java 发出 TOOL_PAUSED,但不发出其他工作流特定事件。其余行适用于两种语言。
| Event Type | 捕获时机 | Key Payload Fields | View |
|---|---|---|---|
USER_MESSAGE_RECEIVED |
用户消息进入调用时 | 文本摘要 / 内容片段 | v_user_message_received |
INVOCATION_STARTING |
调用开始时 | (仅公共列) | v_invocation_starting |
INVOCATION_COMPLETED |
调用结束时 | (仅公共列) | v_invocation_completed |
INVOCATION_ERROR |
调用因未处理异常而失败时 | 错误消息、清理后的堆栈跟踪 | v_invocation_error |
AGENT_STARTING |
智能体执行开始时 | 指令摘要 | v_agent_starting |
AGENT_COMPLETED |
智能体执行结束时 | 延迟 | v_agent_completed |
AGENT_ERROR |
智能体执行因未处理异常而失败时 | 错误消息、清理后的堆栈跟踪、延迟 | v_agent_error |
LLM_REQUEST |
发送模型请求时 | 模型、提示、配置、工具 | v_llm_request |
LLM_RESPONSE |
收到模型响应时 | 响应、使用 token、缓存元数据、完成原因、延迟、TTFT | v_llm_response |
LLM_ERROR |
模型调用失败时 | 错误消息、延迟 | v_llm_error |
TOOL_STARTING |
工具开始执行时 | 工具名称、参数、来源 | v_tool_starting |
TOOL_COMPLETED |
工具执行成功时 | 工具名称、结果、来源、延迟 | v_tool_completed |
TOOL_ERROR |
工具执行失败时 | 工具名称、参数、来源、错误、延迟 | v_tool_error |
STATE_DELTA |
会话状态变更时 | 状态增量 | v_state_delta |
HITL_CREDENTIAL_REQUEST |
发出凭据请求时 | 合成工具名称、参数 | v_hitl_credential_request |
HITL_CONFIRMATION_REQUEST |
发出确认请求时 | 合成工具名称、参数 | v_hitl_confirmation_request |
HITL_INPUT_REQUEST |
发出用户输入请求时 | 合成工具名称、参数 | v_hitl_input_request |
HITL_CREDENTIAL_REQUEST_COMPLETED |
用户提供凭据响应时 | 合成工具名称、结果 | (仅基础表) |
HITL_CONFIRMATION_REQUEST_COMPLETED |
用户提供确认响应时 | 合成工具名称、结果 | (仅基础表) |
HITL_INPUT_REQUEST_COMPLETED |
用户提供输入响应时 | 合成工具名称、结果 | (仅基础表) |
A2A_INTERACTION |
远程 A2A 调用完成时 | 响应、任务 ID、上下文 ID、请求/响应 | v_a2a_interaction |
AGENT_RESPONSE |
产出最终智能体响应时 | 响应(内容)、源事件 ID/作者/分支(属性) | v_agent_response |
AGENT_TRANSFER |
一个智能体将控制权移交给另一个时 | 源智能体、目标智能体、源事件 ID | v_agent_transfer |
AGENT_STATE_CHECKPOINT |
智能体快照其状态(或标记其运行结束)时 | 智能体状态、智能体结束标志、源事件 ID | v_agent_state_checkpoint |
EVENT_COMPACTION |
一组事件窗口被压缩为摘要时 | 窗口开始/结束时间戳、压缩内容 | v_event_compaction |
TOOL_PAUSED |
长时间运行的工具(或 HITL 请求)挂起等待恢复时 | 工具名称、参数、暂停类型、函数调用 ID | v_tool_paused |
NODE_OUTPUT |
工作流节点发出最终结构化输出时 | 输出、节点路径、运行 ID、父运行 ID | v_node_output |
NODE_ERROR |
工作流节点以非模型错误结束时 | 错误代码、错误消息、节点路径、运行 ID、父运行 ID | v_node_error |
安装
对于 Python,请安装带有专用 BigQuery Agent Analytics 额外依赖的 ADK。该额外依赖包含插件所需的 BigQuery 客户端、Cloud Storage 客户端和 pyarrow:
pyarrow 依赖不再包含在通用 gcp 额外依赖中。如果缺少 pyarrow,插件的导入错误会提示你需要安装的 bigquery-analytics 额外依赖。
快速入门
将插件添加到你的智能体的 App 对象中。前置条件请参见前置条件。
import os
from google.adk.agents import Agent
from google.adk.apps import App
from google.adk.models.google_llm import Gemini
from google.adk.plugins.bigquery_agent_analytics_plugin import BigQueryAgentAnalyticsPlugin

os.environ['GOOGLE_CLOUD_PROJECT'] = 'your-gcp-project-id'
os.environ['GOOGLE_CLOUD_LOCATION'] = 'us-central1'
os.environ['GOOGLE_GENAI_USE_ENTERPRISE'] = 'True'

plugin = BigQueryAgentAnalyticsPlugin(
    project_id="your-gcp-project-id",
    dataset_id="your-big-query-dataset-id",
)

root_agent = Agent(
    model=Gemini(model="gemini-flash-latest"),
    name='my_agent',
    instruction="你是一个得力助手。",
)

app = App(
    name="my_agent",
    root_agent=root_agent,
    plugins=[plugin],
)
将插件添加到你的运行器的插件列表中。前置条件请参见前置条件。
import com.google.adk.agents.LlmAgent;
import com.google.adk.agents.RunConfig;
import com.google.adk.models.Gemini;
import com.google.adk.plugins.Plugin;
import com.google.adk.plugins.agentanalytics.BigQueryAgentAnalyticsPlugin;
import com.google.adk.plugins.agentanalytics.BigQueryLoggerConfig;
import com.google.adk.runner.InMemoryRunner;
import com.google.common.collect.ImmutableList;

public final class Agent {
  public static void main(String[] args) throws Exception {
    Plugin bqLoggingPlugin = new BigQueryAgentAnalyticsPlugin(
        BigQueryLoggerConfig.builder()
            .projectId("your-gcp-project-id")
            .datasetId("your-big-query-dataset-id")
            .tableName("agent_events") // Optional; default in v1.8.0+
            .build());

    InMemoryRunner runner = new InMemoryRunner(
        LlmAgent.builder()
            .model(Gemini.builder().modelName("gemini-2.5-flash").build())
            .name("my_agent")
            .instruction("你是一个得力助手。")
            .build(),
        "my_agent",
        ImmutableList.of(bqLoggingPlugin));

    // 使用运行器 ...

    // 关闭运行器以刷新和关闭插件
    runner.close().blockingAwait();
  }
}
将插件添加到你的智能体的 App 对象中。前置条件请参见前置条件。该插件仅限 JVM,且位于核心之外,因此需要添加集成构件:
import com.google.adk.kt.agents.Instruction
import com.google.adk.kt.agents.LlmAgent
import com.google.adk.kt.apps.App
import com.google.adk.kt.models.Gemini
import com.google.adk.kt.plugins.agentanalytics.BigQueryAgentAnalyticsPlugin
import com.google.adk.kt.plugins.agentanalytics.BigQueryLoggerConfig

val analyticsAgent =
    LlmAgent(
        name = "my_agent",
        model = Gemini(name = "gemini-flash-latest"),
        instruction = Instruction("You are a helpful assistant."),
    )

/**
 * Wraps [analyticsAgent] in an [App] whose invocations are logged to BigQuery.
 *
 * The plugin creates the day-partitioned table on first use, so the credentials
 * in scope need permission to create a table in the dataset, not only to insert
 * rows. Without explicit `credentials`, application default credentials are used.
 *
 * Logging failures never fail the turn: a table that cannot be created, or a row
 * that cannot be inserted, is logged and the invocation carries on.
 */
fun analyticsApp(
    projectId: String,
    datasetId: String,
    datasetLocation: String,
): App {
    val plugin =
        BigQueryAgentAnalyticsPlugin(
            config =
                BigQueryLoggerConfig(
                    projectId = projectId,
                    datasetId = datasetId,
                    // Defaults to "US"; pass your dataset's location instead.
                    location = datasetLocation,
                ),
        )

    return App(
        appName = "my_agent",
        rootAgent = analyticsAgent,
        plugins = listOf(plugin),
    )
}
该插件在首次使用时创建事件表,因此作用域中的凭据需要具有在数据集中创建表的权限,而不仅仅是插入行。将 location 设置为你的数据集位置;默认为 "US"。有关完整的选项集,请参见配置选项。
日志记录永远不会导致轮次失败:如果无法创建表或无法插入行,插件会记录错误,调用会继续。当行缺失时,请为 com.google.adk.kt.plugins.agentanalytics.BigQueryAgentAnalyticsPlugin 启用日志记录——日志会以该类名发出,而不是使用插件的 ADK 名称(bigquery_agent_analytics)。
通过运行智能体并通过聊天界面发出一些请求来测试插件,例如"告诉我你能做什么"或"列出我的云项目
SELECT timestamp, event_type, content
FROM `your-gcp-project-id.your-big-query-dataset-id.agent_events`
ORDER BY timestamp DESC
LIMIT 20;
包含 GCS 卸载、OpenTelemetry 和 BigQuery 工具的完整示例
# my_bq_agent/agent.py
import os
import google.auth
from google.adk.apps import App
from google.adk.plugins.bigquery_agent_analytics_plugin import BigQueryAgentAnalyticsPlugin, BigQueryLoggerConfig
from google.adk.agents import Agent
from google.adk.models.google_llm import Gemini
from google.adk.tools.bigquery import BigQueryToolset, BigQueryCredentialsConfig


# --- OpenTelemetry 说明(BQAA 无需额外设置) ---
# BQAA 插件不会自行导出 OTel span。它在内部栈上追踪
# 父子层级:根调用 span 在有活跃环境 OTel span 时
# 重用其 id(作为 16 位十六进制字符串),子 BQAA span
# 在内部生成为 16 位十六进制字符串。插件的 `trace_id`
# 列继承自智能体运行时周围活跃的 OpenTelemetry span:
#   * Agent Engine 自动连接其调用 span,因此
#     BigQuery 中的 `trace_id` 开箱即用地关联到 Cloud Trace。
#   * 在本地,框架插桩的运行器会为你打开调用 span。
#   * 如果两者都不可用,插件会回退到每次调用生成一个
#     trace_id,父子层级仍保留在
#     BigQuery 中;无需 OTel 设置。
# 设置一个没有环境 span 的裸 `TracerProvider` 不会导致
# `trace_id` 被填充为"真实的" OTel id;只有*活跃的*
# span 才会。详见"追踪和可观测性"部分。

# --- 配置 ---
PROJECT_ID = os.environ.get("GOOGLE_CLOUD_PROJECT", "your-gcp-project-id")
DATASET_ID = os.environ.get("BIG_QUERY_DATASET_ID", "your-big-query-dataset-id")
# GOOGLE_CLOUD_LOCATION 必须是有效的 Agent Platform 区域(例如 "us-central1")。
# BQ_LOCATION 是 BigQuery 数据集位置,可以是多区域
# 如 "US" 或 "EU",也可以是单个区域如 "us-central1"。
VERTEX_LOCATION = os.environ.get("GOOGLE_CLOUD_LOCATION", "us-central1")
BQ_LOCATION = os.environ.get("BQ_LOCATION", "US")
GCS_BUCKET = os.environ.get("GCS_BUCKET_NAME", "your-gcs-bucket-name") # 可选

if PROJECT_ID == "your-gcp-project-id":
    raise ValueError("请设置 GOOGLE_CLOUD_PROJECT 或更新代码。")

# --- 关键:在 Gemini 实例化之前设置环境变量 ---
os.environ['GOOGLE_CLOUD_PROJECT'] = PROJECT_ID
os.environ['GOOGLE_CLOUD_LOCATION'] = VERTEX_LOCATION
os.environ['GOOGLE_GENAI_USE_ENTERPRISE'] = 'True'

# --- 初始化插件并配置 ---
bq_config = BigQueryLoggerConfig(
    enabled=True,
    gcs_bucket_name=GCS_BUCKET, # 启用 GCS 卸载以处理多模态内容
    log_multi_modal_content=True,
    max_content_length=500 * 1024, # 500 KB 内联文本限制
    batch_size=1, # 默认为 1 以获得低延迟,增加可提高吞吐量
    shutdown_timeout=10.0
)

bq_logging_plugin = BigQueryAgentAnalyticsPlugin(
    project_id=PROJECT_ID,
    dataset_id=DATASET_ID,
    table_id="agent_events", # 默认表名为 agent_events
    config=bq_config,
    location=BQ_LOCATION
)

# --- 初始化工具和模型 ---
credentials, _ = google.auth.default(scopes=["https://www.googleapis.com/auth/cloud-platform"])
bigquery_toolset = BigQueryToolset(
    credentials_config=BigQueryCredentialsConfig(credentials=credentials)
)

llm = Gemini(model="gemini-flash-latest")

root_agent = Agent(
    model=llm,
    name='my_bq_agent',
    instruction="你是一个可以访问 BigQuery 工具的得力助手。",
    tools=[bigquery_toolset]
)

# --- 创建 App ---
app = App(
    name="my_bq_agent",
    root_agent=root_agent,
    plugins=[bq_logging_plugin],
)
package adk.plugins.agentanalytics.demo;

import static java.nio.charset.StandardCharsets.UTF_8;
import static java.util.Collections.singletonList;

import com.google.adk.agents.LlmAgent;
import com.google.adk.agents.RunConfig;
import com.google.adk.events.Event;
import com.google.adk.models.Gemini;
import com.google.adk.plugins.Plugin;
import com.google.adk.plugins.agentanalytics.BigQueryAgentAnalyticsPlugin;
import com.google.adk.plugins.agentanalytics.BigQueryLoggerConfig;
import com.google.adk.runner.InMemoryRunner;
import com.google.adk.sessions.Session;
import com.google.adk.tools.FunctionTool;
import com.google.adk.tools.ToolContext;
import com.google.genai.types.Content;
import com.google.genai.types.GenerateContentConfig;
import com.google.genai.types.Part;
import io.opentelemetry.sdk.OpenTelemetrySdk;
import io.opentelemetry.sdk.common.CompletableResultCode;
import io.opentelemetry.sdk.trace.SdkTracerProvider;
import io.opentelemetry.sdk.trace.data.SpanData;
import io.opentelemetry.sdk.trace.export.SimpleSpanProcessor;
import io.opentelemetry.sdk.trace.export.SpanExporter;
import io.reactivex.rxjava3.core.Flowable;
import java.util.Collection;
import java.util.Scanner;

/** 演示如何使用 BigQueryAgentAnalyticsPlugin 的示例智能体。 */
public final class BqDemoAgent {
  private static final String PROJECT_ID = "your-gcp-project-id";
  private static final String DATASET_ID = "your-gcp-dataset_id";
  private static final String TABLE_ID = "your-gcp-table";
  private static final String GCS_BUCKET_NAME = "your-gcs-bucket-name";
  private static final String API_KEY = "your-api_key";

  // 用于演示工具执行日志记录的简单工具
  public static String reverseString(String input, ToolContext toolContext) {
    return new StringBuilder(input).reverse().toString();
  }

  public static void main(String[] args) throws Exception {
    // 0. 初始化 OpenTelemetry
    initOpenTelemetry();

    // 1. 配置 BigQuery 日志记录器
    BigQueryLoggerConfig config =
        BigQueryLoggerConfig.builder()
            .projectId(PROJECT_ID)
            .datasetId(DATASET_ID)
            .tableName(TABLE_ID)
            .gcsBucketName(GCS_BUCKET_NAME)
            .createViews(true)
            .build();

    // 2. 创建插件实例
    Plugin bqLoggingPlugin = new BigQueryAgentAnalyticsPlugin(config);

    // 3. 初始化模型(Gemini)
    Gemini model =
        Gemini.builder()
            .modelName("gemini-3-flash-preview") // 使用适当的模型
            .apiKey(API_KEY)
            .build();

    // 4. 创建包含工具和插件的智能体
    LlmAgent agent =
        LlmAgent.builder()
            .model(model)
            .name("bq_demo_agent")
            .instruction(
                "你是一个得力助手。你有一个 'reverseString' 工具可以用来反转文本。")
            .tools(FunctionTool.create(BqDemoAgent.class, "reverseString"))
            .generateContentConfig(GenerateContentConfig.builder().temperature(0.5f).build())
            .build();

    // 5. 初始化运行器
    InMemoryRunner runner =
        new InMemoryRunner(agent, "bq_demo_agent", singletonList(bqLoggingPlugin));

    // 6. 创建会话
    Session session =
        runner.sessionService().createSession(runner.appName(), "demo_user").blockingGet();

    RunConfig runConfig = RunConfig.builder().build();

    System.out.println("智能体已就绪。输入 'quit' 退出。");

    try (Scanner scanner = new Scanner(System.in, UTF_8)) {
      while (true) {
        System.out.print("\n用户:");
        String userInput = scanner.nextLine();
        if (userInput.trim().equalsIgnoreCase("quit")) {
          break;
        }

        Content userMsg = Content.fromParts(Part.fromText(userInput));

        // 运行智能体并流式传输事件
        Flowable<Event> events =
            runner.runAsync(session.userId(), session.id(), userMsg, runConfig);

        System.out.print("智能体:");
        events.blockingForEach(
            event -> {
              if (event.finalResponse()) {
                System.out.println(event.stringifyContent());
              }
            });
      }
    } finally {
      System.out.println("正在关闭运行器(刷新剩余日志)...");
      runner.close().blockingAwait();
      System.out.println("完成。");
    }
  }

  private static void initOpenTelemetry() {
    PrintingSpanExporter exporter = new PrintingSpanExporter();
    SdkTracerProvider tracerProvider =
        SdkTracerProvider.builder().addSpanProcessor(SimpleSpanProcessor.create(exporter)).build();
    OpenTelemetrySdk.builder().setTracerProvider(tracerProvider).buildAndRegisterGlobal();
  }

  private static class PrintingSpanExporter implements SpanExporter {
    @Override
    public CompletableResultCode export(Collection<SpanData> spans) {
      for (SpanData span : spans) {
        System.out.println("--- Span: " + span.getName() + " ---");
        System.out.println("  TraceId: " + span.getTraceId());
        System.out.println("  SpanId: " + span.getSpanId());
        System.out.println("  ParentSpanId: " + span.getParentSpanId());
        System.out.println("  Attributes: " + span.getAttributes());
        System.out.println("------------------------");
      }
      return CompletableResultCode.ofSuccess();
    }

    @Override
    public CompletableResultCode flush() {
      return CompletableResultCode.ofSuccess();
    }

    @Override
    public CompletableResultCode shutdown() {
      return CompletableResultCode.ofSuccess();
    }
  }

  private BqDemoAgent() {}
}
部署到 Agent Runtime?
前置条件
- Google Cloud 项目,已启用 BigQuery API。
- BigQuery 数据集:在使用插件之前创建一个数据集来存储日志表。如果表不存在,插件会在数据集中自动创建必要的事件表。
- Google Cloud 存储桶(可选):如果你计划记录多模态内容(图像、音频等),建议创建一个 GCS 存储桶用于卸载大文件。
- 身份验证:
- 本地:运行
gcloud auth application-default login。 - 云端:确保你的服务账号具有所需权限。
注意:Gemini 模型选择器 gemini-flash-latest
ADK 文档中的大多数代码示例使用 gemini-flash-latest 来选择最新可用的 Gemini Flash 版本。但是,如果你通过区域端点(例如 us-central1)访问 Gemini,此选择字符串可能无效。在这种情况下,请使用 Gemini 模型页面或 Google Cloud Gemini 模型列表中的特定模型版本字符串。
IAM 权限
为了使智能体正常工作,运行智能体的主体(例如服务账号、用户账号)需要以下 Google Cloud 角色:
- 项目级别的
roles/bigquery.jobUser,用于运行 BigQuery 查询。 - 表级别的
roles/bigquery.dataEditor,用于写入日志/事件数据。 - 如果使用 GCS 卸载:目标存储桶上的
roles/storage.objectCreator和roles/storage.objectViewer。
配置选项
构造函数参数
BigQueryAgentAnalyticsPlugin 构造函数接受以下参数。它还接受 **kwargs,这些参数会直接转发给 BigQueryLoggerConfig(见下文)。
| 参数 | 类型 | 默认值 | 使用场景 |
|---|---|---|---|
project_id |
str |
(必填) | 选择 Google Cloud 项目 |
dataset_id |
str |
(必填) | 选择 BigQuery 数据集 |
table_id |
Optional[str] |
None |
使用自定义表名(覆盖 config 中的 table_id) |
config |
Optional[BigQueryLoggerConfig] |
None |
传入配置对象进行详细调优 |
location |
str |
"US" |
匹配 BigQuery 数据集位置(例如 "US"、"EU"、"us-central1") |
credentials |
Optional[google.auth.credentials.Credentials] |
None |
使用显式服务账号、模拟或跨项目凭据,替代 ADC |
plugin = BigQueryAgentAnalyticsPlugin(
    project_id="my-project",
    dataset_id="my_dataset",
    batch_size=10,           # 转发给 BigQueryLoggerConfig
    shutdown_timeout=5.0,    # 转发给 BigQueryLoggerConfig
)
BigQueryLoggerConfig 选项
以下所有选项均为可选的,并且具有合理的默认值。将它们传递给 BigQueryLoggerConfig 或作为 **kwargs 传递给插件构造函数。
| 选项 | 类型 | 默认值 | 使用场景 |
|---|---|---|---|
enabled |
bool |
True |
临时禁用日志记录 |
table_id |
str |
"agent_events" |
使用自定义表名(构造函数值优先) |
clustering_fields |
List[str] |
["event_type", "agent", "user_id"] |
自定义表创建时的聚簇字段 |
gcs_bucket_name |
Optional[str] |
None |
将大文本和多模态内容卸载到 GCS |
connection_id |
Optional[str] |
None |
使用 BigQuery ObjectRef / 对象表(例如 us.my-connection) |
max_content_length |
int |
500 * 1024 |
控制卸载/截断前的内联负载大小 |
batch_size |
int |
1 |
调优写入吞吐量与延迟 |
batch_flush_interval |
float |
1.0 |
定期刷新部分批次(秒) |
shutdown_timeout |
float |
10.0 |
关闭时等待最终刷新(秒) |
event_allowlist |
Optional[List[str]] |
None |
仅记录选定的事件类型 |
event_denylist |
Optional[List[str]] |
None |
跳过敏感或嘈杂的事件类型 |
content_formatter |
Optional[Callable] |
None |
对每个事件应用自定义脱敏/格式化(接收 (content, event_type)) |
log_multi_modal_content |
bool |
True |
捕获包含 GCS 引用的 content_parts 详情 |
queue_max_size |
int |
10000 |
限制内存中的事件队列大小 |
retry_config |
RetryConfig |
RetryConfig() |
调优重试行为(max_retries=3、initial_delay=1.0、multiplier=2.0、max_delay=10.0) |
log_session_metadata |
bool |
True |
将会话信息添加到 attributes(session_id、app_name、user_id、state)。以 temp: 为前缀的键会被脱敏。 |
custom_tags |
Dict[str, Any] |
{} |
向每个事件的 attributes 添加静态标签(例如 {"env": "prod"}) |
auto_schema_upgrade |
bool |
True |
自动向现有表添加新列(仅追加) |
create_views |
bool |
True |
创建按事件类型划分的 BigQuery 视图 |
view_prefix |
str |
"v" |
多个插件共享数据集时避免视图名称冲突(例如 "v_staging") |
enable_otel_correlation |
bool |
False |
将环境 OpenTelemetry span 上下文捕获到 attributes.otel.{span_id, trace_id} 作为尽力而为的 Cloud Trace 关联键 |
custom_metadata_allowlist |
Optional[List[str]] |
None |
将选定的 event.custom_metadata 键捕获到 attributes.custom_metadata.*:精确键或 "prefix*" 模式 |
payload_column_denylist |
Optional[List[str]] |
None |
在写入时从表中投影掉负载列(content、content_parts、attributes、latency_ms) |
final_response_tool_names |
FrozenSet[str] |
frozenset() |
将选定成功工具的调用参数记录为 AGENT_RESPONSE 负载 |
flush_on_run_end |
bool |
True |
在每次运行结束时等待排队的行完成写入 |
exactly_once_delivery |
bool |
False |
使用已提交流和显式偏移量来防止实时处理器中因模糊重试导致的重复 |
以下代码示例展示了如何为 BigQuery Agent Analytics 插件定义配置:
import json
import re
from typing import Any

from google.adk.plugins.bigquery_agent_analytics_plugin import BigQueryLoggerConfig

def redact_dollar_amounts(event_content: Any, event_type: str) -> str:
    """
    用于脱敏金额(例如 $600、$12.50)
    的自定义格式化器,并在输入为字典时确保 JSON 输出。

    参数:
        event_content:事件的原始内容。
        event_type:事件类型字符串(例如 "LLM_REQUEST"、"LLM_RESPONSE")。
    """
    text_content = ""
    if isinstance(event_content, dict):
        text_content = json.dumps(event_content)
    else:
        text_content = str(event_content)

    # 使用正则表达式查找金额:$ 后跟数字,可选逗号或小数。
    # 示例:$600、$1,200.50、$0.99
    redacted_content = re.sub(r'\$\d+(?:,\d{3})*(?:\.\d+)?', 'xxx', text_content)

    return redacted_content

config = BigQueryLoggerConfig(
    enabled=True,
    event_allowlist=["LLM_REQUEST", "LLM_RESPONSE"], # 仅记录这些事件
    # event_denylist=["TOOL_STARTING"], # 跳过这些事件
    shutdown_timeout=10.0, # 退出时最多等待 10 秒让日志刷新
    max_content_length=500, # 将内容截断为 500 字符
    content_formatter=redact_dollar_amounts, # 脱敏日志内容中的金额
    queue_max_size=10000, # 内存中最多持有的事件数
    auto_schema_upgrade=True, # 自动向现有表添加新列
    create_views=True, # 自动创建按事件类型划分的视图
    # retry_config=RetryConfig(max_retries=3), # 可选:配置重试
)

plugin = BigQueryAgentAnalyticsPlugin(
    project_id="my-project",
    dataset_id="my_dataset",
    config=config,
)
追踪关联、元数据捕获和列投影
三个选项控制哪些额外上下文进入 attributes,以及是否写入负载列。每个选项都在上面的 BigQueryLoggerConfig 选项表中列出;以下说明补充了扁平表无法表达的跨选项规则:
enable_otel_correlation:捕获的 span 上下文是尽力而为的 Cloud Trace 关联键,不是外键;禁用时(默认)不写入attributes.otel。custom_metadata_allowlist:不设置时保留旧行为,仅运行内置的a2a:*捕获。捕获的值经过与所有其他记录内容相同的安全流水线(截断、敏感键脱敏、循环引用处理)。payload_column_denylist:仅可列出content、content_parts、attributes和latency_ms;标识列和关联列受保护且会抛出ValueError。投影以模式优先方式应用,因此表模式、写入的行和自动创建的视图保持一致(视图会丢弃依赖于被拒绝列的派生列)。拒绝attributes也会禁用attributes.otel和attributes.custom_metadata,将其与非空的custom_metadata_allowlist组合会在构造时被拒绝。
config = BigQueryLoggerConfig(
    enable_otel_correlation=True,                      # 与 Cloud Trace 关联的 join 键
    custom_metadata_allowlist=["ticket_id", "exp:*"],  # 捕获选定的 custom_metadata 键
    # payload_column_denylist=["content_parts"],       # 不持久化多模态负载
)
最终回答捕获和运行结束刷新
当智能体通过调用专用工具(而非产出纯文本最终事件)来交付最终回答时,使用 final_response_tool_names。在成功的匹配工具调用时,插件将工具的调用参数写为 AGENT_RESPONSE 行,并在 attributes 中添加 source_tool。
flush_on_run_end 选项默认为 True,这使得 after_run_callback 会等待当前事件循环的写入队列。设置为 False 可从响应路径中移除该刷新;后台写入器将继续排空队列,因此行可能会在运行返回后不久出现在 BigQuery 中。
config = BigQueryLoggerConfig(
    final_response_tool_names=frozenset({"submit_final_response"}),
    flush_on_run_end=False,
)
交付和去重
每一行在入队前都会收到一个 32 字符的十六进制 event_id。当 Storage Write API 重试该行时,相同的 ID 会被重用,使其成为默认交付模式中的去重键:
SELECT *
FROM `your-gcp-project-id.adk_agent_logs.agent_events`
QUALIFY
  event_id IS NULL
  OR ROW_NUMBER() OVER (PARTITION BY event_id ORDER BY timestamp) = 1;
event_id IS NULL 条件保留了在该列引入之前写入的行。
设置 exactly_once_delivery=True 以使用单个循环本地的已提交流和显式偏移量。这可以防止首次结果模糊的重试在该处理器的生命周期内创建重复项。当需要轮换流时,可能会消耗额外的 BigQuery CreateWriteStream 配额。
尽管名称如此,此选项并非无损交付保证。批次在重试耗尽、偏移量冲突或替换流失败后仍可能被丢弃。流轮换失败后,在 30 秒轮换退避期间到达的事件也会被丢弃。监控 offset_conflict 和其他丢弃原因,并保留 event_id 作为消费者去重键。
在 Java 中,所有配置都通过 BigQueryLoggerConfig 构建器进行管理。
BigQueryLoggerConfig 构建器选项
| 构建器方法 | 类型 | 默认值 | 描述 |
|---|---|---|---|
enabled(boolean) |
boolean |
true |
临时禁用日志记录 |
projectId(String) |
String |
(必填) | 选择 Google Cloud 项目 |
datasetId(String) |
String |
(必填) | 选择 BigQuery 数据集 |
tableName(String) |
String |
"agent_events" |
使用自定义表名 |
location(String) |
String |
"us" |
匹配 BigQuery 数据集位置 |
clusteringFields(List<String>) |
List<String> |
["event_type", "agent", "user_id"] |
自定义表创建时的聚簇字段 |
gcsBucketName(String) |
String |
"" |
将大文本和多模态内容卸载到 GCS |
connectionId(String) |
String |
null |
使用 BigQuery ObjectRef / 对象表 |
maxContentLength(int) |
int |
500 * 1024 |
控制卸载/截断前的内联负载大小 |
batchSize(int) |
int |
1 |
调优写入吞吐量与延迟 |
batchFlushInterval(Duration) |
Duration |
Duration.ofSeconds(1) |
定期刷新部分批次 |
shutdownTimeout(Duration) |
Duration |
Duration.ofSeconds(10) |
关闭时等待最终刷新 |
eventAllowlist(List<String>) |
List<String> |
[] |
仅记录选定的事件类型 |
eventDenylist(List<String>) |
List<String> |
[] |
跳过敏感或嘈杂的事件类型 |
contentFormatter(BiFunction) |
BiFunction<Object, String, Object> |
null |
对每个事件应用自定义脱敏/格式化 |
logMultiModalContent(boolean) |
boolean |
true |
捕获包含 GCS 引用的 content_parts 详情 |
queueMaxSize(int) |
int |
10000 |
限制内存中的事件队列大小 |
retryConfig(RetryConfig) |
RetryConfig |
RetryConfig.builder().build() |
调优重试行为 |
logSessionMetadata(boolean) |
boolean |
true |
将会话信息添加到 attributes |
customTags(Map<String, Object>) |
Map<String, Object> |
{} |
向每个事件的 attributes 添加静态标签 |
autoSchemaUpgrade(boolean) |
boolean |
true |
自动向现有表添加新列 |
createViews(boolean) |
boolean |
false |
创建按事件类型划分的 BigQuery 视图(注意:默认为 false,与 Python 的 true 不同) |
viewPrefix(String) |
String |
"v" |
避免视图名称冲突 |
credentials(Credentials) |
Credentials |
null |
使用显式服务账号凭据 |
在 Java v1.8.0 及更高版本中,datasetId 是必填项,tableName 默认为 "agent_events"。Java v1.7.0 及更早版本分别将这些值默认为 "agent_analytics" 和 "events"。
以下代码示例展示了如何在 Java 中为 BigQuery Agent Analytics 插件定义配置:
import com.google.adk.plugins.agentanalytics.BigQueryAgentAnalyticsPlugin;
import com.google.adk.plugins.agentanalytics.BigQueryLoggerConfig;
import java.time.Duration;
import java.util.function.BiFunction;

// 用于脱敏金额的自定义格式化器
BiFunction<Object, String, Object> redactDollarAmounts = (content, eventType) -> {
  String textContent = content.toString();
  return textContent.replaceAll("\\$\\d+(?:,\\d{3})*(?:\\.\\d+)?", "xxx");
};

BigQueryLoggerConfig config = BigQueryLoggerConfig.builder()
    .enabled(true)
    .projectId("my-project")
    .datasetId("my_dataset")
    .tableName("agent_events")
    .batchSize(1)
    .batchFlushInterval(Duration.ofMillis(500))
    .contentFormatter(redactDollarAmounts)
    .autoSchemaUpgrade(true)
    .createViews(true)
    .build();

BigQueryAgentAnalyticsPlugin plugin = new BigQueryAgentAnalyticsPlugin(config);
在 Kotlin 中,所有配置通过 BigQueryLoggerConfig 数据类管理,插件将其作为唯一必需的参数。
BigQueryLoggerConfig 属性
| 选项 | 类型 | 默认值 | 使用场景 |
|---|---|---|---|
projectId |
String |
(必填) | 选择 Google Cloud 项目 |
datasetId |
String |
(必填) | 选择 BigQuery 数据集 |
enabled |
Boolean |
true |
临时禁用日志记录 |
location |
String |
"US" |
匹配 BigQuery 数据集位置(例如 "EU" 或 "us-central1") |
tableName |
String |
"agent_events" |
使用自定义表名 |
credentials |
Credentials? |
null |
使用显式服务账号凭据,替代 ADC |
以下代码示例展示了如何在 Kotlin 中为 BigQuery Agent Analytics 插件定义配置:
import com.google.adk.kt.plugins.agentanalytics.BigQueryAgentAnalyticsPlugin
import com.google.adk.kt.plugins.agentanalytics.BigQueryLoggerConfig

val config =
    BigQueryLoggerConfig(
        projectId = "my-project",
        datasetId = "my_dataset",
        location = "EU",
        tableName = "agent_events",
    )

val plugin = BigQueryAgentAnalyticsPlugin(config = config)
Python 和 Java 选项卡下列出的选项,如批处理、内容格式化、事件允许列表、GCS 卸载和视图创建,在 Kotlin 中不存在。
模式参考
事件表(agent_events)使用灵活的模式。下表提供了包含示例值的全面参考。
| 字段名 | 类型 | 模式 | 描述 | 示例值 |
|---|---|---|---|---|
| timestamp | TIMESTAMP |
REQUIRED |
事件创建的 UTC 时间戳。作为主要排序键和每日分区键。精度为微秒。 | 2026-02-03 20:52:17 UTC |
| event_type | STRING |
NULLABLE |
标准事件类别。标准值包括 LLM_REQUEST、LLM_RESPONSE、LLM_ERROR、TOOL_STARTING、TOOL_COMPLETED、TOOL_ERROR、AGENT_STARTING、AGENT_COMPLETED、STATE_DELTA、INVOCATION_STARTING、INVOCATION_COMPLETED、USER_MESSAGE_RECEIVED、HITL 事件(参见 HITL 事件),以及 ADK 2.0 工作流事件 AGENT_TRANSFER、AGENT_STATE_CHECKPOINT、EVENT_COMPACTION 和 TOOL_PAUSED(参见智能体工作流和暂停/恢复事件)。用于高级过滤。 |
LLM_REQUEST |
| agent | STRING |
NULLABLE |
负责此事件的智能体名称。在智能体初始化时或通过 root_agent_name 上下文定义。 |
my_bq_agent |
| session_id | STRING |
NULLABLE |
整个对话线程的持久标识符。在多次轮次和子智能体调用中保持不变。 | 04275a01-1649-4a30-b6a7-5b443c69a7bc |
| invocation_id | STRING |
NULLABLE |
单次执行轮次或请求周期的唯一标识符。在许多上下文中对应于 trace_id。 |
e-b55b2000-68c6-4e8b-b3b3-ffb454a92e40 |
| user_id | STRING |
NULLABLE |
发起会话的用户(人类或系统)的标识符。从 User 对象或元数据中提取。 |
test_user |
| trace_id | STRING |
NULLABLE |
32 字符十六进制 Trace ID。当存在环境 OpenTelemetry 跨度(例如 Agent Engine 的调用跨度或 ADK Runner 跨度)时继承该跨度,以便 BigQuery 行与你现有的 Cloud Trace 追踪无缝关联;否则由插件每次调用时生成。链接单个分布式请求生命周期中的所有操作。 | a2c7f13d3a3f0bbb8793692f76a6012a |
| span_id | STRING |
NULLABLE |
16 字符十六进制 Span ID,标识此特定原子操作。在插件的内部栈上追踪,不作为 OTel 跨度导出——插件不会对你配置的 OpenTelemetry 提供者调用 tracer.start_span。根调用跨度在有活跃环境 OTel 跨度时重用其 id;子跨度在内部生成(参见追踪和可观测性)。 |
3916f5762bcd4d42 |
| parent_span_id | STRING |
NULLABLE |
直接调用者的 16 字符十六进制 Span ID。用于重建父子执行树 (DAG)。 | 4c4a42bfdeb84934 |
| content | JSON |
NULLABLE |
主要事件负载。结构根据 event_type 而多态变化。 |
{"system_prompt": "You are...", "prompt": [{"role": "user", "content": "hello"}], "response": "Hi", "usage": {"total": 15}} |
| attributes | JSON |
NULLABLE |
元数据/增强信息(使用统计、模型信息、工具来源、自定义标签)。 | {"model": "gemini-flash-latest", "usage_metadata": {"total_token_count": 15}, "session_metadata": {"session_id": "...", "app_name": "...", "user_id": "...", "state": {}}, "custom_tags": {"env": "prod"}} |
| latency_ms | JSON |
NULLABLE |
性能指标。标准键为 total_ms(挂钟耗时)和 time_to_first_token_ms(流式延迟)。 |
{"total_ms": 1250, "time_to_first_token_ms": 450} |
| status | STRING |
NULLABLE |
高级别结果。值:OK(成功)或 ERROR(失败)。 |
OK |
| error_message | STRING |
NULLABLE |
人类可读的异常消息或堆栈跟踪片段。仅在 status 为 ERROR 时填充。 |
Error 404: Dataset not found |
| is_truncated | BOOLEAN |
NULLABLE |
如果 content 或 attributes 超过 BigQuery 单元格大小限制(默认 10MB)并被部分丢弃,则为 true。 |
false |
| content_parts | RECORD |
REPEATED |
多模态片段数组(文本、图像、Blob)。当内容无法序列化为简单 JSON 时使用(例如大二进制文件或 GCS 引用)。 | [{"mime_type": "text/plain", "text": "hello"}] |
| Field Name | 类型 | 模式 | 描述 | 示例值 |
|---|---|---|---|---|
| timestamp | TIMESTAMP |
REQUIRED |
事件创建的 UTC 时间戳。作为主要排序键和每日分区键。精度为微秒。 | 2026-02-03 20:52:17 UTC |
| event_id | STRING |
NULLABLE |
入队前分配的 32 字符十六进制 ID。Storage Write API 重试会保留该 ID,以便消费者识别重复行。在模式版本 2 之前写入的行值为 NULL。 |
ca5e3c9d99e24e46b614f2f44f93bf6e |
| event_type | STRING |
NULLABLE |
规范事件类别。标准值包括 LLM、工具、智能体、调用、状态、HITL、A2A、响应、工作流、节点输出和节点错误事件,详见事件类型和负载。用于高级过滤。 | LLM_REQUEST |
| agent | STRING |
NULLABLE |
负责此事件的智能体名称。在智能体初始化时或通过 root_agent_name 上下文定义。 |
my_bq_agent |
| session_id | STRING |
NULLABLE |
整个对话线程的持久标识符。在多次轮次和子智能体调用中保持不变。 | 04275a01-1649-4a30-b6a7-5b443c69a7bc |
| invocation_id | STRING |
NULLABLE |
单次执行轮次或请求周期的唯一标识符。在许多上下文中对应于 trace_id。 |
e-b55b2000-68c6-4e8b-b3b3-ffb454a92e40 |
| user_id | STRING |
NULLABLE |
发起会话的用户(人类或系统)的标识符。从 User 对象或元数据中提取。 |
test_user |
| trace_id | STRING |
NULLABLE |
追踪标识符。当从环境 span 继承时(例如 Agent Engine 的调用 span 或 ADK Runner span),它是 32 字符十六进制 OpenTelemetry trace ID,因此 BigQuery 行可以干净地关联到你现有的 Cloud Trace 追踪。没有环境 span 时,Python 也以该格式作为每次调用的回退,而 Java 则回退到 ADK 调用 ID。链接单个分布式请求生命周期中的所有操作。 | a2c7f13d3a3f0bbb8793692f76a6012a |
| span_id | STRING |
NULLABLE |
16 字符十六进制 Span ID,标识此特定原子操作。在插件的内部栈上追踪,不作为 OTel span 导出。 插件不会对你配置的 OpenTelemetry 提供者调用 tracer.start_span。根调用 span 在有活跃环境 OTel span 时重用其 id;子 span 在内部生成(参见追踪和可观测性)。 |
3916f5762bcd4d42 |
| parent_span_id | STRING |
NULLABLE |
直接调用者的 16 字符十六进制 Span ID。用于重建父子执行树 (DAG)。 | 4c4a42bfdeb84934 |
| content | JSON |
NULLABLE |
主要事件负载。结构根据 event_type 而多态变化。 |
{"system_prompt": "You are...", "prompt": [{"role": "user", "content": "hello"}], "response": "Hi", "usage": {"total": 15}} |
| attributes | JSON |
NULLABLE |
元数据/增强信息(使用统计、模型信息、工具来源、自定义标签)。 | {"model": "gemini-flash-latest", "usage_metadata": {"total_token_count": 15}, "session_metadata": {"session_id": "...", "app_name": "...", "user_id": "...", "state": {}}, "custom_tags": {"env": "prod"}} |
| latency_ms | JSON |
NULLABLE |
性能指标。标准键为 total_ms(挂钟耗时)和 time_to_first_token_ms(流式延迟)。 |
{"total_ms": 1250, "time_to_first_token_ms": 450} |
| status | STRING |
NULLABLE |
高级别结果。值:OK(成功)或 ERROR(失败)。 |
OK |
| error_message | STRING |
NULLABLE |
用于异常和模型终止详情的清理后诊断消息。在 Python 中,它可以在 status 仍为 OK 的最终 LLM_RESPONSE 上被填充。 |
Error 404: Dataset not found |
| is_truncated | BOOLEAN |
NULLABLE |
当内容或元数据被截断或被安全边界替换时为 true,包括配置的 max_content_length、清理器深度或节点预算以及诊断文本清理。普通的结构化敏感键脱敏本身不会设置此标志。 |
false |
| content_parts | RECORD |
REPEATED |
多模态片段数组(文本、图像、Blob)。当内容无法序列化为简单 JSON 时使用(例如大二进制文件或 GCS 引用)。 | [{"mime_type": "text/plain", "text": "hello"}] |
在 Python 中,event_id 列是模式版本 2 的一部分。使用 auto_schema_upgrade=True(默认),插件会自动将其添加到现有表中。如果你自行管理表模式,请在使用 ADK Python v2.7.0 或更高版本之前添加该列。
Java 模式不包含 event_id。从下方手动 DDL 创建的表仍与 Java 兼容,因为该列是可空的。
在 Kotlin 中,插件使用相同的列创建表,但仅填充 timestamp、event_type、agent、session_id、invocation_id、user_id 和 content。其余列始终为空。
生产环境手动 DDL
CREATE TABLE `your-gcp-project-id.adk_agent_logs.agent_events`
(
  timestamp TIMESTAMP NOT NULL OPTIONS(description="事件记录的 UTC 时间。"),
  event_id STRING OPTIONS(description="入队前分配的唯一 ID,在 Storage Write API 重试中保持不变。"),
  event_type STRING OPTIONS(description="指示被记录事件的类型(例如 'LLM_REQUEST'、'TOOL_COMPLETED')。"),
  agent STRING OPTIONS(description="与事件关联的 ADK 智能体或作者的名称。"),
  session_id STRING OPTIONS(description="用于在单个对话或用户会话中分组事件的唯一标识符。"),
  invocation_id STRING OPTIONS(description="会话中每个单独智能体执行或轮次的唯一标识符。"),
  user_id STRING OPTIONS(description="与当前会话关联的用户标识符。"),
  trace_id STRING OPTIONS(description="32 字符十六进制 trace ID。当存在活跃的环境 OpenTelemetry span 时继承自该 span;否则由插件每次调用时生成。"),
  span_id STRING OPTIONS(description="16 字符十六进制 span ID,用于此特定操作。在插件的内部栈上追踪;根调用 span 可能重用环境 OTel span id,而子 BQAA span 在内部生成。不会创建或导出 OpenTelemetry span。"),
  parent_span_id STRING OPTIONS(description="直接调用者的 16 字符十六进制 span ID,用于重建父子执行树。"),
  content JSON OPTIONS(description="以 JSON 存储的事件特定数据(负载)。"),
  content_parts ARRAY<STRUCT<
    mime_type STRING,
    uri STRING,
    object_ref STRUCT<
      uri STRING,
      version STRING,
      authorizer STRING,
      details JSON
    >,
    text STRING,
    part_index INT64,
    part_attributes STRING,
    storage_mode STRING
  >> OPTIONS(description="多模态数据的详细内容片段。"),
  attributes JSON OPTIONS(description="用于附加元数据的任意键值对(例如 'root_agent_name'、'model_version'、'usage_metadata'、'session_metadata'、'custom_tags')。"),
  latency_ms JSON OPTIONS(description="延迟测量(例如 total_ms)。"),
  status STRING OPTIONS(description="事件的结果,通常为 'OK' 或 'ERROR'。"),
  error_message STRING OPTIONS(description="清理后的错误或模型终止诊断信息。"),
  is_truncated BOOLEAN OPTIONS(description="标志指示内容是否被截断。")
)
PARTITION BY DATE(timestamp)
CLUSTER BY event_type, agent, user_id;
自动创建的视图
在 Python 中,create_views=True(默认)会自动为每种事件类型生成视图。在 Java 中,设置 createViews(true);其默认值为 false。Kotlin 不创建视图。这些视图将常见的 JSON 结构展开为扁平的类型化列,避免了重复的 JSON_VALUE 和 JSON_QUERY 表达式。
视图名称遵循 {view_prefix}_{event_type_lowercase} 的约定(例如,使用默认前缀 "v" 时,LLM_REQUEST 变为 v_llm_request)。当多个插件实例写入同一数据集中的不同表时,在 BigQueryLoggerConfig 中设置 view_prefix 为不同的值,以防止视图名称冲突:
# 同一数据集中的两个插件,使用不同的视图前缀
plugin_prod = BigQueryAgentAnalyticsPlugin(
    project_id=PROJECT_ID, dataset_id=DATASET_ID,
    table_id="agent_events_prod",
    config=BigQueryLoggerConfig(view_prefix="v_prod"),
)
# 创建视图:v_prod_llm_request、v_prod_tool_completed 等

plugin_staging = BigQueryAgentAnalyticsPlugin(
    project_id=PROJECT_ID, dataset_id=DATASET_ID,
    table_id="agent_events_staging",
    config=BigQueryLoggerConfig(view_prefix="v_staging"),
)
# 创建视图:v_staging_llm_request、v_staging_tool_completed 等
你也可以调用公共异步方法 await plugin.create_analytics_views() 来手动刷新视图,例如在模式升级之后。
每个 Python 视图都包含以下公共列:timestamp、event_id、event_type、agent、session_id、invocation_id、user_id、trace_id、span_id、parent_span_id、status、error_message、is_truncated。Java 视图包含相同的公共列,但不包含 event_id。
下表列出了 Python 视图及其事件专用列:
| 视图名称 | 事件专用列 |
|---|---|
v_user_message_received |
(仅公共列) |
v_llm_request |
model (STRING), request_content (JSON), llm_config (JSON), tools (JSON) |
v_llm_response |
response (JSON), usage_prompt_tokens (INT64), usage_completion_tokens (INT64), usage_total_tokens (INT64), usage_cached_tokens (INT64), usage_thinking_tokens (INT64), usage_tool_use_tokens (INT64), context_cache_hit_rate (FLOAT64), total_ms (INT64), ttft_ms (INT64), model_version (STRING), usage_metadata (JSON), cache_metadata (JSON), cache_type (STRING), finish_reason (STRING) |
v_llm_error |
total_ms (INT64) |
v_tool_starting |
tool_name (STRING), tool_args (JSON), tool_origin (STRING) |
v_tool_completed |
tool_name (STRING), tool_result (JSON), tool_origin (STRING), total_ms (INT64), pause_kind (STRING), function_call_id (STRING) |
v_tool_error |
tool_name (STRING), tool_args (JSON), tool_origin (STRING), total_ms (INT64) |
v_agent_starting |
agent_instruction (STRING) |
v_agent_completed |
total_ms (INT64) |
v_agent_error |
total_ms (INT64), error_traceback (STRING) |
v_invocation_starting |
(仅公共列) |
v_invocation_completed |
(仅公共列) |
v_invocation_error |
error_traceback (STRING) |
v_state_delta |
state_delta (JSON) |
v_hitl_credential_request |
tool_name (STRING), tool_args (JSON) |
v_hitl_confirmation_request |
tool_name (STRING), tool_args (JSON) |
v_hitl_input_request |
tool_name (STRING), tool_args (JSON) |
v_a2a_interaction |
response_content (JSON), a2a_task_id (STRING), a2a_context_id (STRING), a2a_request (JSON), a2a_response (JSON) |
v_agent_response |
response_text (STRING), source_event_id (STRING), source_event_author (STRING), source_event_branch (STRING) |
v_agent_transfer |
from_agent (STRING), to_agent (STRING), source_event_id (STRING) |
v_agent_state_checkpoint |
agent_state (JSON), agent_state_type (STRING), end_of_agent (BOOL), source_event_id (STRING) |
v_event_compaction |
start_seconds (FLOAT64), end_seconds (FLOAT64), window_start (TIMESTAMP), window_end (TIMESTAMP), compacted_content (JSON,包含格式化的摘要字符串) |
v_tool_paused |
tool_name (STRING), tool_args (JSON), pause_kind (STRING), function_call_id (STRING) |
v_node_output |
node_path (STRING), node_run_id (STRING), node_parent_run_id (STRING), output (JSON) |
v_node_error |
node_path (STRING), node_run_id (STRING), node_parent_run_id (STRING), error_code (STRING) |
四个工作流视图(v_agent_transfer、v_agent_state_checkpoint、v_event_compaction、v_tool_paused)以及 v_tool_completed 上的 pause_kind / function_call_id 列随 ADK 2.0 工作流事件支持提供。在 Java(v1.7.0+)中,仅创建 v_tool_paused 和 v_tool_completed 上的 pause_kind / function_call_id 列;v_agent_transfer、v_agent_state_checkpoint 和 v_event_compaction 仅限 Python(Java 插件不发出这些事件)。v_node_output 和 v_node_error 视图在 Python v2.7.0 及更高版本中可用。
Java 视图的其他差异如下:
- Java 不创建
v_agent_error、v_invocation_error、v_node_output或v_node_error,因为它不发出这些事件。 - Java 的
v_llm_response截止到usage_metadata;它不暴露usage_thinking_tokens、usage_tool_use_tokens、cache_metadata、cache_type或finish_reason。 - Java 的
v_agent_response暴露text_summary而非response_text。 - Java 的
v_a2a_interaction省略a2a_response;响应仍可在response_content中获取。
事件类型和负载
content 列现在包含一个特定于 event_type 的 JSON 对象。content_parts 列提供了内容的结构化视图,特别适用于图像或已卸载的数据。
内容截断
- 可变内容字段会被截断至
max_content_length(在BigQueryLoggerConfig中配置,默认 500KB)。 - 如果配置了
gcs_bucket_name,大内容会卸载到 GCS 而非截断,并在content_parts.object_ref中存储引用。
LLM 交互(插件生命周期)
这些事件追踪发送给 LLM 的原始请求和从 LLM 接收的响应。
1. LLM_REQUEST
捕获发送给模型的提示,包括对话历史和系统指令。
{
  "event_type": "LLM_REQUEST",
  "content": {
    "system_prompt": "You are a helpful assistant...",
    "prompt": [
      {
        "role": "user",
        "content": "hello how are you today"
      }
    ]
  },
  "attributes": {
    "root_agent_name": "my_bq_agent",
    "model": "gemini-flash-latest",
    "tools": ["list_dataset_ids", "execute_sql"],
    "llm_config": {
      "temperature": 0.5,
      "top_p": 0.9
    }
  }
}
自动创建的 v_llm_request 视图将 tools 属性展开为其 tools(JSON)列。
2. LLM_RESPONSE
捕获模型的输出和 token 使用统计。
{
  "event_type": "LLM_RESPONSE",
  "content": {
    "response": "text: 'Hello! I'm doing well...'",
    "usage": {
      "completion": 19,
      "prompt": 10129,
      "total": 10148
    }
  },
  "attributes": {
    "root_agent_name": "my_bq_agent",
    "model_version": "gemini-flash-latest",
    "usage_metadata": {
      "prompt_token_count": 10129,
      "candidates_token_count": 19,
      "total_token_count": 10148
    },
    "finish_reason": "STOP"
  },
  "latency_ms": {
    "time_to_first_token_ms": 2579,
    "total_ms": 2579
  }
}
Python 插件仅在最终、非部分响应中添加 finish_reason。其 v_llm_response 视图将其暴露为 STRING 类型,同时包含最终响应的 cache_type。当模型提供终止诊断时,即使该行的 status 仍为 OK,它也会在公共 error_message 列中存储清理后的值。
在 Python 中,模型完成和阻止原因仍归类为 LLM_RESPONSE。插件仅在模型调用抛出异常时使用 LLM_ERROR。
3. LLM_ERROR
当 LLM 调用因异常失败时记录。错误消息会被捕获,并且 span 被关闭。
{
  "event_type": "LLM_ERROR",
  "content": null,
  "attributes": {
    "root_agent_name": "my_bq_agent"
  },
  "error_message": "Error 429: Resource exhausted",
  "latency_ms": {
    "total_ms": 350
  }
}
工具使用(插件生命周期)
这些事件追踪智能体对工具的执行情况。每个工具事件包含一个 tool_origin 字段,用于分类工具的来源:
| 工具来源 | 描述 |
|---|---|
LOCAL |
FunctionTool 实例(本地 Python 函数) |
MCP |
Model Context Protocol 工具(McpTool 实例) |
SUB_AGENT |
AgentTool 实例(子智能体) |
A2A |
远程 Agent2Agent 实例(RemoteA2aAgent) |
TRANSFER_AGENT |
TransferToAgentTool 实例(通用智能体传输) |
TRANSFER_A2A |
仅 Python:传输到 RemoteA2aAgent 的 TransferToAgentTool 实例(在调用级别分类) |
UNKNOWN |
未分类的工具 |
4. TOOL_STARTING
当智能体开始执行工具时记录。
{
  "event_type": "TOOL_STARTING",
  "content": {
    "tool": "list_dataset_ids",
    "args": {
      "project_id": "bigquery-public-data"
    },
    "tool_origin": "LOCAL"
  }
}
5. TOOL_COMPLETED
当工具执行完成时记录。
{
  "event_type": "TOOL_COMPLETED",
  "content": {
    "tool": "list_dataset_ids",
    "result": ["austin_311", "austin_bikeshare"],
    "tool_origin": "LOCAL"
  },
  "latency_ms": {
    "total_ms": 467
  }
}
6. TOOL_ERROR
当工具执行因异常失败时记录。捕获工具名称、参数、工具来源和错误消息。
{
  "event_type": "TOOL_ERROR",
  "content": {
    "tool": "list_dataset_ids",
    "args": {
      "project_id": "nonexistent-project"
    },
    "tool_origin": "LOCAL"
  },
  "error_message": "Error 404: Dataset not found",
  "latency_ms": {
    "total_ms": 150
  }
}
状态管理
这些事件追踪智能体状态的变更,通常由工具触发。
7. STATE_DELTA
追踪智能体内部状态的变更(例如,由工具更新的自定义应用程序状态)。
内置脱敏
以 temp: 为前缀的状态键在记录的 state_delta 中会自动脱敏为 [REDACTED]。详情请参见内置脱敏。
{
  "event_type": "STATE_DELTA",
  "attributes": {
    "state_delta": {
      "customer_tier": "enterprise",
      "last_query_dataset": "bigquery-public-data.samples"
    }
  }
}
智能体生命周期和通用事件
| 事件类型 | 内容(JSON)结构 |
|---|---|
INVOCATION_STARTING |
{} |
INVOCATION_COMPLETED |
{} |
INVOCATION_ERROR |
{"error_traceback": "..."} |
AGENT_STARTING |
"You are a helpful agent..." |
AGENT_COMPLETED |
{} |
AGENT_ERROR |
{"error_traceback": "..."} |
USER_MESSAGE_RECEIVED |
{"text_summary": "Help me book a flight."} |
AGENT_RESPONSE |
{"response": "Here are the flights..."} |
在 Python 中,AGENT_ERROR 和 INVOCATION_ERROR 行的 status="ERROR",包含清理后的 error_message,以及 content 中清理后的堆栈跟踪。智能体错误视图还暴露了耗时 total_ms。这些事件代表了逃逸出智能体或运行器执行的未处理异常。
在 Kotlin 中,两个调用事件携带摘要消息而非空对象:{"message": "Invocation started"} 和 {"message": "Invocation completed"}。
AGENT_RESPONSE
当智能体向用户产出最终响应时记录。响应文本存储在 content 中,而源事件元数据存储在 attributes 中。
{
  "event_type": "AGENT_RESPONSE",
  "content": {
    "response": "Here are the available flights..."
  },
  "attributes": {
    "source_event_id": "evt-abc123",
    "source_event_author": "flight_agent",
    "source_event_branch": "main"
  }
}
此示例展示的是 Python 负载。Java 将可见内容摘要存储为 {"text_summary": "Here are the available flights..."} 并在 v_agent_response 中将该字段暴露为 text_summary。
在 Python 中,如果 final_response_tool_names 包含成功完成的工具名称,插件还会发出 AGENT_RESPONSE,将该工具的调用参数作为响应负载,并在 attributes 中添加 source_tool。这支持通过专用工具(而非可见文本事件)交付最终回答的智能体。
人在回路 (HITL) 事件
插件会自动检测对 ADK 合成 HITL 工具的调用,并为它们发出专用的事件类型。这些事件在正常的 TOOL_STARTING / TOOL_COMPLETED 事件之外额外记录。
识别以下 HITL 工具名称:
adk_request_credential:请求用户凭据(例如 OAuth 令牌)adk_request_confirmation:请求用户确认后再继续adk_request_input:请求自由格式的用户输入
| 事件类型 | 触发条件 | 内容(JSON)结构 |
|---|---|---|
HITL_CREDENTIAL_REQUEST |
智能体调用 adk_request_credential |
{"tool": "adk_request_credential", "args": {...}} |
HITL_CREDENTIAL_REQUEST_COMPLETED |
用户提供凭据响应 | {"tool": "adk_request_credential", "result": {...}} |
HITL_CONFIRMATION_REQUEST |
智能体调用 adk_request_confirmation |
{"tool": "adk_request_confirmation", "args": {...}} |
HITL_CONFIRMATION_REQUEST_COMPLETED |
用户提供确认响应 | {"tool": "adk_request_confirmation", "result": {...}} |
HITL_INPUT_REQUEST |
智能体调用 adk_request_input |
{"tool": "adk_request_input", "args": {...}} |
HITL_INPUT_REQUEST_COMPLETED |
用户提供输入响应 | {"tool": "adk_request_input", "result": {...}} |
HITL 请求事件通过 on_event_callback 中的 function_call 片段检测。HITL 完成事件通过 on_event_callback 和 on_user_message_callback 中的 function_response 片段检测。
HITL 事件的视图
自动创建的视图仅适用于三种请求事件类型(v_hitl_credential_request、v_hitl_confirmation_request、v_hitl_input_request)。三种 *_COMPLETED 事件类型会记录到基础表,但没有专用视图。直接从 agent_events 表中使用 WHERE event_type LIKE 'HITL_%_COMPLETED' 查询。
A2A 交互事件
当你的智能体通过 Agent2Agent(A2A)协议与远程智能体通信时,插件会记录一个 A2A_INTERACTION 事件,捕获请求和响应详情。
A2A_INTERACTION
当 A2A 远程智能体调用完成时记录。
{
  "event_type": "A2A_INTERACTION",
  "content": { "message": "The remote agent's response..." },
  "attributes": {
    "a2a_metadata": {
      "a2a:task_id": "task-abc123",
      "a2a:context_id": "ctx-def456",
      "a2a:request": { ... },
      "a2a:response": { "message": "The remote agent's response..." }
    }
  }
}
此示例展示的是 Python 负载。两种实现都将响应直接存储在 content 中。Python 还在 attributes.a2a_metadata 中保留带命名空间的响应;Java 省略该重复项。Python 的 v_a2a_interaction 视图暴露 response_content、a2a_task_id、a2a_context_id、a2a_request 和 a2a_response。Java 省略最后一列。
智能体工作流和暂停/恢复事件 (ADK 2.0)
Java 支持
Java 插件支持本节的子集:它发出 TOOL_PAUSED 和下面描述的暂停/恢复配对,但不发出 AGENT_TRANSFER、AGENT_STATE_CHECKPOINT 或 EVENT_COMPACTION,也不写入 attributes.adk 信封。Java 插件将 pause_kind 和 function_call_id 存储在 attributes 的顶层(参见下方的查询说明)。
ADK 2.0 引入了多智能体工作流(智能体传输控制权、检查点其状态并压缩长历史记录)和跨轮次暂停/恢复的长时间运行工具。插件通过四种新的事件类型和一个小型元数据信封 attributes.adk 使这些流程可观测,该信封将行与产生它们的 ADK 事件关联起来。
attributes.adk 信封
此信封仅由 Python 插件写入。每一行现在都携带一个 attributes.adk 对象。schema_version 和 app_name 始终存在;其余字段仅在行源自 ADK 事件(生命周期和工作流事件)时添加,因此在仅回调的行上它们是缺失的(查询时解析为 SQL NULL)。
| 字段 | 类型 | 含义 |
|---|---|---|
schema_version |
string | 信封版本(当前为 "1")。当信封演进时,在下游查询中以此为条件。 |
app_name |
string | 产生该行的 ADK 应用。 |
source_event_id |
string | 源 ADK Event 的 ID。将单个事件产生的多行关联的可靠键。 |
node |
object | 工作流节点标识:{ "path", "run_id", "parent_run_id" }。parent_run_id 是父节点的运行 ID(根节点为 null)。 |
branch |
string | 事件的分支,当工作流运行分支路径时。 |
scope |
object | 隔离作用域 { "id", "kind" },其中 kind 为 node_run(工作流节点运行,例如 loopA@42)、function_call(模型生成的调用 ID)或 unknown。 |
route |
string | 事件操作选择的路由(当设置时)。 |
render_ui_widgets |
array | 事件操作请求的序列化 UI 小部件(当设置时)。 |
rewind_before_invocation_id |
string | 事件操作请求回退到之前的调用 ID(当设置时)。 |
pause_kind |
string | 在 TOOL_PAUSED 上:tool 表示常规长时间运行工具,hitl_credential / hitl_confirmation / hitl_input 表示 HITL 请求。在恢复的 TOOL_COMPLETED 行上始终为 tool;HITL 完成记录为 HITL_*_REQUEST_COMPLETED,而非 TOOL_COMPLETED。 |
function_call_id |
string | 函数调用 ID。在 TOOL_PAUSED 和匹配的恢复 TOOL_COMPLETED 行上设置,以便配对两者(仅限普通工具)。 |
查询信封
使用 JSON_VALUE(attributes, '$.adk.<field>') 读取信封字段(对于 node / scope 对象使用 JSON_QUERY)。自动创建的视图已经将常用字段(source_event_id、pause_kind、function_call_id)展开为扁平列,因此大多数查询可以使用视图代替。
AGENT_TRANSFER
当一个智能体将控制权移交给另一个智能体时记录(例如,协调器路由到专业子智能体)。
{
  "event_type": "AGENT_TRANSFER",
  "content": {
    "from_agent": "coordinator",
    "to_agent": "flight_agent"
  },
  "attributes": {
    "adk": { "source_event_id": "evt-abc123" }
  }
}
AGENT_STATE_CHECKPOINT
当智能体快照其状态时记录。插件还会发出一个 end_of_agent: true 的检查点来标记智能体运行结束。v_agent_state_checkpoint 视图展开 agent_state_type,以便你区分真实的状态对象、显式的 null 检查点(运行结束标记)和缺失值。
{
  "event_type": "AGENT_STATE_CHECKPOINT",
  "content": {
    "agent_state": { "step": 3, "retries": 0 },
    "end_of_agent": false
  },
  "attributes": {
    "adk": { "source_event_id": "evt-def456" }
  }
}
EVENT_COMPACTION
当 ADK 将早期事件窗口压缩为摘要时记录(用于在上下文窗口内保持长对话)。时间戳为小数纪元秒;视图还将它们展开为 BigQuery TIMESTAMP 列(window_start、window_end)。compacted_content 包含插件格式化的压缩窗口文本(字符串),而非结构化对象。
{
  "event_type": "EVENT_COMPACTION",
  "content": {
    "start_timestamp": 1733856000.123,
    "end_timestamp": 1733856120.456,
    "compacted_content": "User booked a flight to SFO, then asked about baggage..."
  }
}
NODE_OUTPUT 和 NODE_ERROR
对于具有工作流节点路径的最终、非部分事件,插件会按适用情况发出节点特定的终止行:
- 当
event.output存在且节点不使用其消息作为输出时,发出NODE_OUTPUT。事件输出直接存储在content中。 - 当
event.error_code存在且不是模型完成或阻止原因时,发出NODE_ERROR。代码存储在content.error_code中,清理后的消息存储在error_message中,status为ERROR。
两个自动创建的视图都从 attributes.adk.node 暴露 node_path、node_run_id 和 node_parent_run_id。
{
  "event_type": "NODE_ERROR",
  "content": { "error_code": "VALIDATION_FAILED" },
  "attributes": {
    "adk": {
      "node": {
        "path": "workflow/validate@run-7",
        "run_id": "run-7",
        "parent_run_id": null
      }
    }
  },
  "status": "ERROR",
  "error_message": "Input did not satisfy the node contract"
}
TOOL_PAUSED 和暂停/恢复配对
普通长时间运行的工具在产出时发出 TOOL_PAUSED 行,在结果到达时(通常在后续轮次)发出 TOOL_COMPLETED 行。两行都携带相同的 function_call_id 和 pause_kind 值 tool,因此你可以将暂停与其完成配对,并测量工具被挂起的时间。(HITL 请求也会发出 TOOL_PAUSED,但它们的完成事件以不同方式记录;请参见下方说明。)
{
  "event_type": "TOOL_PAUSED",
  "content": {
    "tool": "request_manager_approval",
    "args": { "amount": 5000 }
  },
  "attributes": {
    "adk": { "pause_kind": "tool", "function_call_id": "call-789" }
  }
}
Java 属性位置
Java 插件将配对键写在 attributes 的顶层,没有 adk 包装器:
"attributes": {"pause_kind": "tool", "function_call_id": "call-789"}。
在下面的基础表查询中,将 '$.adk.pause_kind' / '$.adk.function_call_id' 替换为 '$.pause_kind' / '$.function_call_id'。基于视图的查询对两种语言都有效,因为视图将这些键暴露为扁平列。
Java 还会在 HITL_*_REQUEST_COMPLETED 行上标记相同的顶层配对键,
因此可以将 HITL 的 TOOL_PAUSED 行直接通过 function_call_id 与基础表中的完成事件关联
(HITL 完成事件没有专用视图)。
与 HITL 事件的关系
HITL 请求(adk_request_confirmation 等)仍然按照 HITL 事件中描述的方式发出其专用的 HITL_*_REQUEST 事件。当该请求也是长时间运行的时,插件还会额外发出一个 TOOL_PAUSED 行,其 pause_kind 标识 HITL 类型(例如 hitl_confirmation),这使得 HITL 暂停与工具暂停具有相同的可见性。
但 HITL 完成不会以 TOOL_COMPLETED 的形式到达。 用户的响应记录为相应的 HITL_*_REQUEST_COMPLETED 事件,而非 TOOL_COMPLETED,因此 hitl_* 暂停无法通过下面的工具关联进行配对。要查看 HITL 暂停的解决,请查找其 HITL_*_REQUEST_COMPLETED 事件(参见 HITL 事件)。因此,下面的暂停/恢复查询仅限于普通工具(pause_kind = 'tool')。
使用共享键将暂停的工具与其完成事件配对。在基础表上:
SELECT
  p.timestamp AS paused_at,
  c.timestamp AS resumed_at,
  TIMESTAMP_DIFF(c.timestamp, p.timestamp, SECOND) AS paused_seconds,
  JSON_VALUE(p.content, '$.tool') AS tool_name,
  JSON_VALUE(p.attributes, '$.adk.pause_kind') AS pause_kind
FROM `your-gcp-project-id.adk_agent_logs.agent_events` AS p
JOIN `your-gcp-project-id.adk_agent_logs.agent_events` AS c
  ON  c.event_type = 'TOOL_COMPLETED'
  AND c.session_id = p.session_id
  AND c.user_id = p.user_id
  AND JSON_VALUE(c.attributes, '$.adk.function_call_id')
      = JSON_VALUE(p.attributes, '$.adk.function_call_id')
WHERE p.event_type = 'TOOL_PAUSED'
  AND JSON_VALUE(p.attributes, '$.adk.pause_kind') = 'tool'
ORDER BY paused_at;
或者,更简单地,使用自动创建的视图,它们将 pause_kind 和 function_call_id 展开为扁平列:
SELECT
  p.timestamp AS paused_at,
  c.timestamp AS resumed_at,
  TIMESTAMP_DIFF(c.timestamp, p.timestamp, SECOND) AS paused_seconds,
  p.tool_name,
  p.pause_kind
FROM `your-gcp-project-id.adk_agent_logs.v_tool_paused` AS p
JOIN `your-gcp-project-id.adk_agent_logs.v_tool_completed` AS c
  USING (session_id, user_id, function_call_id)
WHERE p.pause_kind = 'tool'
ORDER BY paused_at;
存储行为:GCS 卸载
当在 BigQueryLoggerConfig 中配置了 gcs_bucket_name 时,插件会自动将大文本和多模态内容(图像、音频等)卸载到 Google Cloud Storage。content 列将包含摘要或占位符,而 content_parts 则存储指向 GCS URI 的 object_ref。另请参见配置选项中的 connection_id 和 max_content_length。
卸载文本示例
{
  "event_type": "LLM_REQUEST",
  "content_parts": [
    {
      "part_index": 1,
      "mime_type": "text/plain",
      "storage_mode": "GCS_REFERENCE",
      "text": "AAAA... [OFFLOADED]",
      "object_ref": {
        "uri": "gs://sample-bucket-name/2025-12-10/e-f9545d6d/ae5235e6_p1.txt",
        "authorizer": "us.bqml_connection",
        "details": { "gcs_metadata": { "content_type": "text/plain" } }
      }
    }
  ]
}
卸载图像示例
{
  "event_type": "LLM_REQUEST",
  "content_parts": [
    {
      "part_index": 2,
      "mime_type": "image/png",
      "storage_mode": "GCS_REFERENCE",
      "text": "[MEDIA OFFLOADED]",
      "object_ref": {
        "uri": "gs://sample-bucket-name/2025-12-10/e-f9545d6d/ae5235e6_p2.png",
        "authorizer": "us.bqml_connection",
        "details": { "gcs_metadata": { "content_type": "image/png" } }
      }
    }
  ]
}
查询卸载内容(获取签名 URL)
SELECT
  timestamp,
  event_type,
  part.mime_type,
  part.storage_mode,
  part.object_ref.uri AS gcs_uri,
  -- 生成签名 URL 以直接读取内容(需要 connection_id 配置)
  STRING(OBJ.GET_ACCESS_URL(part.object_ref, 'r').access_urls.read_url) AS signed_url
FROM `your-gcp-project-id.your-dataset-id.agent_events`,
UNNEST(content_parts) AS part
WHERE part.storage_mode = 'GCS_REFERENCE'
ORDER BY timestamp DESC
LIMIT 10;
查询示例
调试运行
使用 trace_id 追踪特定对话轮次
SELECT timestamp, event_type, agent, JSON_VALUE(content, '$.response') as summary
FROM `your-gcp-project-id.your-dataset-id.agent_events`
WHERE trace_id = 'your-trace-id'
ORDER BY timestamp ASC;
Span 层次结构和耗时分析
SELECT
  span_id,
  parent_span_id,
  event_type,
  timestamp,
  -- 从 latency_ms 中提取已完成操作的持续时间
  CAST(JSON_VALUE(latency_ms, '$.total_ms') AS INT64) as duration_ms,
  -- 标识特定工具或操作
  COALESCE(
    JSON_VALUE(content, '$.tool'),
    'LLM_CALL'
  ) as operation
FROM `your-gcp-project-id.your-dataset-id.agent_events`
WHERE trace_id = 'your-trace-id'
  AND event_type IN ('LLM_RESPONSE', 'TOOL_COMPLETED')
ORDER BY timestamp ASC;
错误分析(LLM 和工具错误)
使用视图(推荐):
-- 带有来源信息的工具错误
SELECT timestamp, agent, tool_name, tool_origin, error_message, total_ms
FROM `your-gcp-project-id.your-dataset-id.v_tool_error`
ORDER BY timestamp DESC
LIMIT 20;

-- LLM 错误
SELECT timestamp, agent, error_message, total_ms
FROM `your-gcp-project-id.your-dataset-id.v_llm_error`
ORDER BY timestamp DESC
LIMIT 20;
监控成本和性能
Token 使用分析
使用 v_llm_response 视图(推荐):
SELECT
  AVG(usage_total_tokens) as avg_tokens,
  AVG(usage_prompt_tokens) as avg_prompt_tokens,
  AVG(usage_completion_tokens) as avg_completion_tokens
FROM `your-gcp-project-id.your-dataset-id.v_llm_response`;
或者使用基础表配合 JSON 提取:
SELECT
  AVG(CAST(JSON_VALUE(content, '$.usage.total') AS INT64)) as avg_tokens
FROM `your-gcp-project-id.your-dataset-id.agent_events`
WHERE event_type = 'LLM_RESPONSE';
延迟分析(LLM 和工具)
使用视图(推荐):
-- LLM 延迟
SELECT AVG(total_ms) as avg_llm_ms, AVG(ttft_ms) as avg_ttft_ms
FROM `your-gcp-project-id.your-dataset-id.v_llm_response`;

-- 按工具名称统计的工具延迟
SELECT tool_name, tool_origin, AVG(total_ms) as avg_tool_ms
FROM `your-gcp-project-id.your-dataset-id.v_tool_completed`
GROUP BY tool_name, tool_origin
ORDER BY avg_tool_ms DESC;
或者使用基础表:
SELECT
  event_type,
  AVG(CAST(JSON_VALUE(latency_ms, '$.total_ms') AS INT64)) as avg_latency_ms
FROM `your-gcp-project-id.your-dataset-id.agent_events`
WHERE event_type IN ('LLM_RESPONSE', 'TOOL_COMPLETED')
GROUP BY event_type;
检查工具和交互
工具来源分析
使用 v_tool_completed 视图(推荐):
SELECT
  tool_origin,
  tool_name,
  COUNT(*) as call_count,
  AVG(total_ms) as avg_latency_ms
FROM `your-gcp-project-id.your-dataset-id.v_tool_completed`
GROUP BY tool_origin, tool_name
ORDER BY call_count DESC;
HITL 交互分析
SELECT
  timestamp,
  event_type,
  session_id,
  JSON_VALUE(content, '$.tool') as hitl_tool,
  content
FROM `your-gcp-project-id.your-dataset-id.agent_events`
WHERE event_type LIKE 'HITL_%'
ORDER BY timestamp DESC
LIMIT 20;
分析多模态内容
查询多模态内容(使用 content_parts 和 ObjectRef)
SELECT
  timestamp,
  part.mime_type,
  part.object_ref.uri as gcs_uri
FROM `your-gcp-project-id.your-dataset-id.agent_events`,
UNNEST(content_parts) as part
WHERE part.mime_type LIKE 'image/%'
ORDER BY timestamp DESC;
使用 BigQuery 远程模型(Gemini)分析多模态内容
SELECT
  logs.session_id,
  -- 获取图像的签名 URL
  STRING(OBJ.GET_ACCESS_URL(parts.object_ref, "r").access_urls.read_url) as signed_url,
  -- 使用远程模型分析图像(例如 gemini-pro-vision)
  AI.GENERATE(
    ('Describe this image briefly. What company logo?', parts.object_ref)
  ) AS generated_result
FROM
  `your-gcp-project-id.your-dataset-id.agent_events` logs,
  UNNEST(logs.content_parts) AS parts
WHERE
  parts.mime_type LIKE 'image/%'
ORDER BY logs.timestamp DESC
LIMIT 1;
AI 驱动的根因分析
使用 BigQuery ML 和 Gemini 自动分析失败的会话,以确定错误的根本原因。
DECLARE failed_session_id STRING;
-- 查找最近的失败会话
SET failed_session_id = (
    SELECT session_id
    FROM `your-gcp-project-id.your-dataset-id.agent_events`
    WHERE error_message IS NOT NULL
    ORDER BY timestamp DESC
    LIMIT 1
);

-- 重建完整对话上下文
WITH SessionContext AS (
    SELECT
        session_id,
        STRING_AGG(CONCAT(event_type, ': ', COALESCE(TO_JSON_STRING(content), '')), '\n' ORDER BY timestamp) as full_history
    FROM `your-gcp-project-id.your-dataset-id.agent_events`
    WHERE session_id = failed_session_id
    GROUP BY session_id
)
-- 让 Gemini 诊断问题
SELECT
    session_id,
    AI.GENERATE(
        ('分析此对话日志并解释失败的根本原因。日志:', full_history),
        endpoint => 'gemini-flash-latest'
    ).result AS root_cause_explanation
FROM SessionContext;
对话分析
你还可以使用 BigQuery 对话分析通过自然语言分析你的智能体日志。在BigQuery Agents Hub中创建一个连接到你的 agent_events 表的对话分析智能体,然后提出如下问题:
- "显示随时间变化的错误率"
- "最常见的工具调用是什么?"
- "找出 token 使用量高的会话"
上下文图
除了行级别的 agent_events,BigQuery 智能体分析 SDK 还可以物化一个上下文图:你的智能体决策的可查询 BigQuery 属性图——它处理的请求、权衡的选项和选择的结果。它让你使用图查询语言(GQL)追踪决策发生的_原因_,而不仅仅是_确认_事件已被记录。
除了行级别的 agent_events,BigQuery 智能体分析 SDK 还可以物化一个上下文图:你的智能体决策的可查询 BigQuery 属性图——它处理的请求、权衡的选项和选择的结果。它让你使用图查询语言(GQL)追踪决策发生的_原因_,而不仅仅是_确认_事件已被记录。
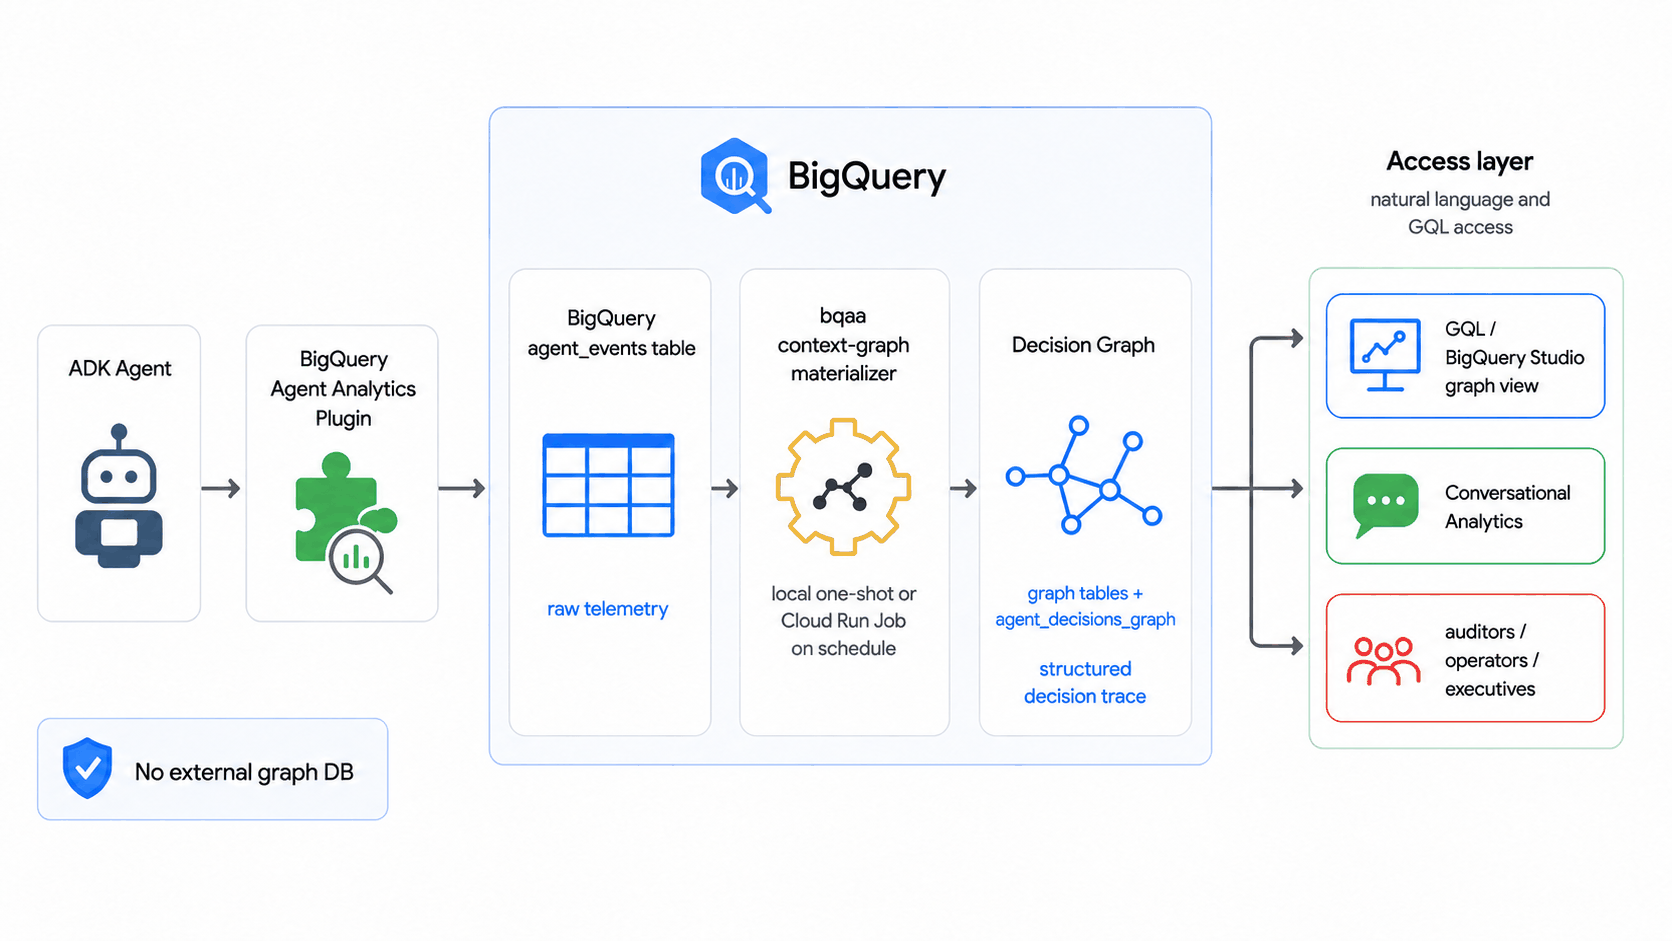
该图由两个声明性工件定义:你的表 DDL 和一个 CREATE PROPERTY GRAPH 模式。SDK 的 bqaa context-graph --property-graph 命令从中加上你的实时表模式推导出提取逻辑(要提取哪些实体和关系及其列类型)。在常见情况下不需要单独的本体或绑定文件;仅当你需要描述来引导 AI 提示、实体继承、派生属性或列重命名时,才使用显式的 ontology.yaml / binding.yaml。
在本地运行一次,或按计划作为由 Cloud Scheduler 触发的 Cloud Run Job 运行,使用分离的只读事件 / 可写图数据集、最小权限服务账号、结构化 JSON 日志和 Cloud Monitoring 告警。操作参考(前置条件、IAM 矩阵、推荐计划、JSON 日志格式、监控和清理)位于 SDK 仓库中:
- 定期物化 Codelab: 端到端构建和查询决策图。
- 定时部署 Runbook: 将该图部署为无人值守的定时部署。
- 部署参考(Cloud Run + Cloud Scheduler): 完整的 IAM 矩阵、计划、监控和 Terraform 模块。
版本要求
使用此插件部署到 Agent Runtime 需要 ADK Python 版本 1.24.0 或更高。早期版本存在一个问题,即在刷新待处理事件之前,插件异步日志写入器可能被无服务器运行时终止。从 1.24.0 开始,该插件在每次调用结束时执行同步刷新,以确保所有事件都被写入。
前置条件
在部署之前,请确保你已完成常规的 Agent Runtime 设置,包括:
- 一个已启用 Agent Platform API 和 Cloud Resource Manager API 的 Google Cloud 项目。
- 目标项目中的 BigQuery 数据集(或具有正确权限的跨项目数据集)。
- 用于部署工件的 Cloud Storage 暂存存储桶。
- 部署服务账号具有 IAM 权限中列出的 IAM 角色。
- 你的编码环境已使用
gcloud auth login和gcloud auth application-default login完成身份验证。
步骤 1:定义智能体和插件
创建一个包含插件的 App 对象的智能体项目文件夹。对于带有插件的 Agent Runtime 部署,App 对象是必需的。
import os
import google.auth
from google.adk.agents import Agent
from google.adk.apps import App
from google.adk.models.google_llm import Gemini
from google.adk.plugins.bigquery_agent_analytics_plugin import (
    BigQueryAgentAnalyticsPlugin,
    BigQueryLoggerConfig,
)
from google.adk.tools.bigquery import BigQueryToolset, BigQueryCredentialsConfig

# --- 配置 ---
PROJECT_ID = os.environ.get("GOOGLE_CLOUD_PROJECT", "your-gcp-project-id")
DATASET_ID = os.environ.get("BQ_DATASET", "agent_analytics")
# BQ_LOCATION 是 BigQuery 数据集位置(多区域 "US"/"EU" 或
# 单个区域如 "us-central1")。这与 GOOGLE_CLOUD_LOCATION 使用的 Agent Platform
# 区域不同。
BQ_LOCATION = os.environ.get("BQ_LOCATION", "US")

os.environ["GOOGLE_GENAI_USE_ENTERPRISE"] = "True"

# --- 插件 ---
bq_analytics_plugin = BigQueryAgentAnalyticsPlugin(
    project_id=PROJECT_ID,
    dataset_id=DATASET_ID,
    location=BQ_LOCATION,
    config=BigQueryLoggerConfig(
        batch_size=1,
        batch_flush_interval=0.5,
        log_session_metadata=True,
    ),
)

# --- 工具 ---
credentials, _ = google.auth.default(
    scopes=["https://www.googleapis.com/auth/cloud-platform"]
)
bigquery_toolset = BigQueryToolset(
    credentials_config=BigQueryCredentialsConfig(credentials=credentials)
)

# --- 智能体 ---
root_agent = Agent(
    model=Gemini(model="gemini-flash-latest"),
    name="my_bq_agent",
    instruction="你是一个可以访问 BigQuery 工具的得力助手。",
    tools=[bigquery_toolset],
)

# --- App(Agent Runtime 使用插件时必需)---
app = App(
    name="my_bq_agent",
    root_agent=root_agent,
    plugins=[bq_analytics_plugin],
)
google-adk[bigquery-analytics]>=2.7.0
opentelemetry-api
opentelemetry-sdk
步骤 2:使用 ADK CLI 部署
使用 adk deploy agent_engine 命令部署智能体。--adk_app 标志告诉 CLI 使用哪个 App 对象:
PROJECT_ID=your-gcp-project-id
LOCATION=us-central1

adk deploy agent_engine \
    --project=$PROJECT_ID \
    --region=$LOCATION \
    --staging_bucket=gs://your-staging-bucket \
    --display_name="My BQ Analytics Agent" \
    --adk_app=agent.app \
    my_bq_agent
--adk_app 标志
--adk_app 标志指定 App 对象的模块路径和变量名(格式为 module.variable)。在此示例中,agent.app 引用 agent.py 中的 app 变量。这确保部署正确获取插件配置。
成功部署后,你应该会看到类似如下的输出:
AgentEngine created. Resource name: projects/123456789/locations/us-central1/reasoningEngines/751619551677906944
请记下 Resource name,以便进行下一步操作。
步骤 3:测试已部署的智能体
部署后,你可以使用 Agent Platform SDK 查询智能体:
import uuid
import vertexai

PROJECT_ID = "your-gcp-project-id"
LOCATION = "us-central1"
AGENT_ID = "751619551677906944"  # 来自部署输出

vertexai.init(project=PROJECT_ID, location=LOCATION)
client = vertexai.Client(project=PROJECT_ID, location=LOCATION)

agent = client.agent_engines.get(
    name=f"projects/{PROJECT_ID}/locations/{LOCATION}/reasoningEngines/{AGENT_ID}"
)

user_id = f"test_user_{uuid.uuid4().hex[:8]}"
for chunk in agent.stream_query(
    message="列出我的项目中的数据集", user_id=user_id
):
    print(chunk, end="", flush=True)
步骤 4:在 BigQuery 中验证事件
向已部署的智能体发送几次查询后,通过查询 BigQuery 表来验证事件是否正在被记录:
SELECT timestamp, event_type, agent, content
FROM `your-gcp-project-id.agent_analytics.agent_events`
ORDER BY timestamp DESC
LIMIT 20;
你应该会看到诸如 INVOCATION_STARTING、LLM_REQUEST、LLM_RESPONSE、TOOL_STARTING、TOOL_COMPLETED 和 INVOCATION_COMPLETED 等事件。
替代方案:使用 Agent Platform SDK 部署
你也可以直接使用 Agent Platform SDK 以编程方式部署。这对于 CI/CD 流水线或自定义部署工作流非常有用:
import vertexai
from my_bq_agent.agent import app

PROJECT_ID = "your-gcp-project-id"
LOCATION = "us-central1"
STAGING_BUCKET = "gs://your-staging-bucket"

vertexai.init(
    project=PROJECT_ID, location=LOCATION, staging_bucket=STAGING_BUCKET
)
client = vertexai.Client(project=PROJECT_ID, location=LOCATION)

remote_app = client.agent_engines.create(
    agent=app,
    config={
        "display_name": "My BQ Analytics Agent",
        "staging_bucket": STAGING_BUCKET,
        "requirements": [
            "google-adk[bigquery-analytics]>=2.7.0",
            "google-cloud-aiplatform[agent_engines]",
            "opentelemetry-api",
            "opentelemetry-sdk",
        ],
    },
)
print(f"Deployed agent: {remote_app.api_resource.name}")
故障排查
如果部署后事件未出现在你的 BigQuery 表中:
-
检查 ADK 版本和额外依赖:确保
google-adk[bigquery-analytics]>=2.7.0在你的 requirements 中。该额外依赖安装了插件所需的 Storage Write API、Cloud Storage 和pyarrow依赖。 -
启用调试日志:在
agent.py顶部添加以下内容以显示任何静默错误:
import logging
logging.basicConfig(level=logging.INFO)
logging.getLogger("google_adk").setLevel(logging.DEBUG)
-
检查 IAM 权限:Agent Runtime 服务账号需要目标表上的
roles/bigquery.dataEditor和项目上的roles/bigquery.jobUser。对于跨项目日志记录,还需确保源项目中已启用 BigQuery API,并且服务账号对目标表具有bigquery.tables.updateData权限。 -
验证插件初始化:在 Cloud Logging 中,按
resource.type="reasoning_engine"过滤,查找插件启动消息或错误日志。 -
使用即时刷新进行调试:在
BigQueryLoggerConfig中设置batch_size=1和batch_flush_interval=0.1,以排除缓冲问题。
安全性:避免记录敏感凭据
请勿记录 OAuth 令牌、API 密钥或客户端密钥
BigQuery Agent Analytics 插件捕获详细的事件负载,包括工具参数、LLM 提示和身份验证相关事件(例如 HITL 凭据请求)。内置脱敏在小写和连字符规范化后精确匹配键名,因此驼峰式变体如 clientSecret 或 accessToken 不会被匹配。ADK 使用驼峰式别名序列化 adk_request_credential 参数,因此 AuthenticatedFunctionTool OAuth2 流程仍可能将 client_secret 和 access_token 值写入 content 列(google/adk-python#3845,仍然开放)。脱敏不是通用的数据泄露防护系统:应用程序特定键下或自由文本中的密钥也可能被写入 BigQuery。
插件包含内置脱敏功能,可自动保护常见的密钥。如需额外控制,你可以在其之上叠加自定义脱敏。
内置脱敏
Python 插件将键名规范化为小写,并将连字符视为下划线。它递归地将以下键在结构化 content 或 attributes 中出现的任何位置替换为 [REDACTED]:
client_secret, access_token, refresh_token, id_token, api_key,
password, private_key, proxy_authorization, google_access_id, sig,
signature, token, secret, authorization, x_api_key,
x_amz_credential, x_amz_signature, x_goog_credential,
x_goog_security_token, x_goog_signature
任何以 temp: 为前缀的键也会被替换为 [REDACTED],包括会话状态和 state_delta 中的键。secret: 前缀不被视为特殊前缀;对于应用程序特定的密钥作用域,请使用 temp: 作用域或自定义格式化器。
对早期指导的更正
本页的早期版本指出 secret: 状态前缀会被自动脱敏。这是不正确的:ADK 仅定义了 app:、user: 和 temp: 状态作用域,插件仅脱敏 temp:。如果你依赖了该指导,请审计你现有的 agent_events 表中非 temp: 键下记录的值。
插件还会清理 error_message、智能体和运行堆栈跟踪以及外部 URI 中的凭据模式。这包括授权头、bearer 和 basic 凭据、签名 URL 查询参数以及使用上述敏感名称的键/值片段。无法安全重写的编码凭据构造会采用失败关闭策略。
无需配置
内置脱敏对结构化属性和状态记录始终有效,并递归应用于属性值中的嵌套字典和 JSON 编码字符串。自定义 content_formatter 在原始内容上首先运行。如果它抛出异常或返回不支持的类型,Python 会写入 [FORMATTER_FAILED] 而非原始内容,并递增 formatter_failed 事件计数器。
Java 中的内置脱敏
Java 插件在 v1.7.0 及更高版本中包含内置脱敏。它在组装的 attributes 树中(包括会话状态和状态增量)递归脱敏 client_secret、access_token、refresh_token、id_token、api_key 和 password(不区分大小写),以及任何以 temp: 为前缀的键。请将密钥保持在其他状态作用域之外,或使用自定义 contentFormatter 进行脱敏。
自定义 Java contentFormatter 必须是线程安全的(它在多个调用之间被并发调用)且快速/非阻塞的(它在事件处理路径上运行),并且必须返回一个新对象而非修改接收到的内容。如果抛出异常,Java 插件会丢弃该行的内容(失败关闭),而不是记录未格式化的负载。
使用 content_formatter 脱敏其他密钥
import json
import re
from typing import Any

SENSITIVE_KEYS = {"client_secret", "access_token", "refresh_token", "api_key", "secret"}

def redact_credentials(event_content: Any, event_type: str) -> str:
    """从记录的内容中脱敏 OAuth 密钥和令牌。"""
    if isinstance(event_content, dict):
        text = json.dumps(event_content)
    else:
        text = str(event_content)

    for key in SENSITIVE_KEYS:
        # 脱敏类 JSON 字符串中的值:"client_secret": "GOCSPX-xxx"
        text = re.sub(
            rf'("{key}"\s*:\s*)"[^"]*"',
            rf'\1"[REDACTED]"',
            text,
            flags=re.IGNORECASE,
        )
    return text

config = BigQueryLoggerConfig(
    content_formatter=redact_credentials,
    # ... 其他选项
)
import com.google.adk.agents.LlmAgent;
import com.google.adk.models.Gemini;
import com.google.adk.models.LlmRequest;
import com.google.adk.models.LlmResponse;
import com.google.adk.runner.Runner;
import com.google.genai.types.Content;
import com.google.genai.types.GenerateContentConfig;
import com.google.genai.types.Part;
import java.util.ArrayList;
import java.util.List;

public final class AgentContentFormatter {
  private static final String PROJECT_ID = "your-gcp-project-id";
  private static final String DATASET_ID = "your-gcp-dataset_id";
  private static final String TABLE_ID = "your-gcp-table";
  private static final String API_KEY = "your-api_key";
  private static final String GCS_BUCKET_NAME = "your-gcs-bucket-name";

  /** 返回你要测试的格式化器逻辑。 */
  private static Object formatter(Object content, String eventType) {
    if (content instanceof LlmRequest req) {
      List<Content> maskedContents = new ArrayList<>();
      for (Content c : req.contents()) {
        maskedContents.add(maskContent(c));
      }
      return req.toBuilder().contents(maskedContents).build();
    } else if (content instanceof LlmResponse res) {
      if (res.content().isPresent()) {
        return res.toBuilder().content(maskContent(res.content().get())).build();
      }
      return res;
    } else if (content instanceof Content content2) {
      return maskContent(content2);
    } else if (content instanceof Map<?, ?> map) {
      Map<Object, Object> maskedMap = new LinkedHashMap<>();
      for (Map.Entry<?, ?> entry : map.entrySet()) {
        maskedMap.put(entry.getKey(), formatter(entry.getValue(), eventType));
      }
      return maskedMap;
    }
    return content;
  }

  private static Content maskContent(Content originalContent) {
    if (originalContent.parts().isPresent()) {
      List<Part> maskedParts = new ArrayList<>();
      for (Part part : originalContent.parts().get()) {
        if (part.text().isPresent() && part.text().get().contains("secret")) {
          String maskedText = part.text().get().replace("secret", "****");
          maskedParts.add(part.toBuilder().text(maskedText).build());
        } else {
          maskedParts.add(part);
        }
      }
      return originalContent.toBuilder().parts(maskedParts).build();
    }
    return originalContent;
  }

  public static void main(String[] args) throws Exception {
    // 1. 使用自定义格式化器设置配置
    BigQueryLoggerConfig config =
        BigQueryLoggerConfig.builder()
            .projectId(PROJECT_ID)
            .datasetId(DATASET_ID)
            .tableName(TABLE_ID)
            .gcsBucketName(GCS_BUCKET_NAME)
            .contentFormatter(AgentContentFormatter::formatter)
            .logMultiModalContent(true)
            .build();

    // 2. 设置插件
    BigQueryAgentAnalyticsPlugin plugin = new BigQueryAgentAnalyticsPlugin(config);

    // 3. 设置响应智能体
    LlmAgent agent =
        LlmAgent.builder()
            .model(
                Gemini.builder()
                    .modelName("gemini-3-flash-preview") // 使用适当的模型
                    .apiKey(API_KEY)
                    .build())
            .name("bq_demo_agent")
            .instruction("You are a helpful assistant")
            .generateContentConfig(GenerateContentConfig.builder().temperature(0.5f).build())
            .build();

    // 4. 设置运行器
    Runner runner = Runner.builder().agent(agent).appName("test_app").plugins(plugin).build();
    // 5. 使用运行器运行一些场景
    ...
  }

  private AgentContentFormatter() {}
}
使用 event_denylist 跳过凭据事件
如果你不需要记录身份验证相关的事件,可以将其完全排除:
通用最佳实践
- 永远不要在智能体源代码中硬编码密钥。使用环境变量或密钥管理服务(例如 Google Cloud Secret Manager)来管理 OAuth 客户端密钥和 API 密钥。
- 使用 IAM 限制 BigQuery 表访问权限,以限制谁可以读取记录的事件数据。
- 定期审计你的日志,确保没有意外的敏感数据被捕获。
操作
追踪与可观测性
插件在每一行中填充 trace_id、span_id 和 parent_span_id 列,以便父子执行树(智能体 → LLM 调用 / 工具调用)可以从 BigQuery 中干净地重建。
- 内部 span 追踪,不导出 OTel span。 插件在自己的 16 位十六进制
span_id值内部栈上追踪父子层级。根调用 span 在有活跃环境 OTel span 时重用其 id(因此与运行器的调用 span 对齐);子 BQAA span 在内部生成。它不会在任何已配置的 OpenTelemetryTracerProvider上调用tracer.start_span(...),因此其插桩永远不会到达你配置的导出器。这就是当 Agent Engine 遥测启用(GOOGLE_CLOUD_AGENT_ENGINE_ENABLE_TELEMETRY=true)或将任何其他 Cloud Trace 导出器连接到宿主进程时,防止 Cloud Trace 中出现重复 span 的原因。同样的内部、仅 ID 的 span 追踪也适用于 Java 插件 v1.7.0 及更高版本;早期 Java 构建创建了插件自有的 OpenTelemetry span,可能会作为框架 span 旁边的重复项出现。 - 有活跃环境 OTel span 时从其继承
trace_id。 如果周围运行时已启动 OTel span,例如 Agent Engine 的调用 span、ADKRunner调用 span 或你在智能体运行之前打开的任何 span。插件读取其trace_id并将其标记到每一行 BigQuery 行上。因此 BigQuery 行通过共享的trace_id干净地关联到你现有的 Cloud Trace 追踪。 - 没有环境 span 时的回退。 如果没有活跃的环境 OTel span(例如没有配置宿主端 tracer 的非 Agent Engine 部署),插件会生成每次调用的 32 位十六进制
trace_id(Java 插件回退到 ADK 调用 ID 作为trace_id),因此父子层级始终保存在 BigQuery 中,即使没有任何外部 tracer 设置。 - 不需要
TracerProvider。 在宿主进程中配置 OpenTelemetryTracerProvider是可选的。仅当你希望插件的trace_id来源于你自己预先存在的环境 span(例如关联来自非 ADK 服务的遥测)时才有意义。插件不再需要该提供者进行自己的记账。
如果你之前依赖插件为 OTel 导出器提供数据
某些旧配置将 BQAA 插件用作 OpenTelemetry span 发射的旁路通道;该路径已被有意移除。请在宿主应用中配置 OTel 插桩(Agent Engine 自动连接;对于本地部署使用 ADK 自己的框架插桩或显式 TracerProvider)。插件的 BigQuery 行将继续通过 trace_id 关联到你的追踪。
公共方法
插件暴露了几个用于生命周期管理的公共方法:
await plugin.flush():等待与当前事件循环关联的待处理事件完成写入。await plugin.shutdown(timeout=None):优雅地关闭插件,刷新待处理事件并释放资源。可选的timeout参数覆盖配置中的shutdown_timeout。await plugin.close():运行插件管理器生命周期契约。它委托给shutdown(),并在运行器关闭其插件时自动调用。await plugin.create_analytics_views():手动(重新)创建所有按事件类型划分的分析视图。在模式升级后或需要刷新视图时很有用。plugin.get_drop_stats():返回按原因分类的交付损失和内容清理事件计数快照。请参见下面的丢弃事件可观测性。-
异步上下文管理器:插件支持
async with以自动启动和关闭:
在 Java 中,插件生命周期通过 close() 方法管理(继承自 Plugin),该方法返回一个 RxJava Completable。
plugin.close():优雅地关闭插件,刷新待处理事件并释放资源(包括 BigQuery 写入客户端和执行器)。- 自动关闭:如果你使用
InMemoryRunner,调用runner.close()会自动关闭所有注册的插件,包括 BigQuery Agent Analytics 插件。 plugin.getDropStats()(v1.7.0+):返回按丢弃原因分类的ImmutableMap<String, Long>丢弃事件计数。请参见丢弃事件可观测性。- JVM 关闭钩子(v1.7.0+):插件在构造时注册一个关闭钩子,因此即使从未调用
close(),待处理事件也会在 JVM 退出时被排空(尽力而为,受shutdownTimeout限制)。显式close()会注销该钩子。仍建议调用close()以获得确定性的刷新。
丢弃事件可观测性
BigQuery 日志记录是尽力而为的。当内存队列溢出、设置不可用、关闭与回调竞争或写入最终失败时,事件可能会被丢弃。插件还会统计格式化器和解析器失败的情况,此时行仍会被写入,但内容被替换为哨兵值。计数器在循环清理和关闭期间持续存在。
丢弃原因(Python):
| 原因 | 原因说明 |
|---|---|
queue_full |
内存批处理队列溢出(宿主产生事件的速度快于排空器的传输速度)。增加 BigQueryLoggerConfig 上的 queue_max_size,提高 batch_size 以更大的块排空,或扩展消费者端(更多并发调用更快完成)。 |
arrow_prep_failed |
行无法转换为其 Arrow 表示(通常是模式/类型不匹配)。检查日志中的问题字段。 |
retry_exhausted |
Storage Write API 调用持续返回可重试错误(例如瞬态 gRPC 失败),直到重试预算用完。 |
non_retryable |
Storage Write API 返回不可重试的错误(权限、配额、模式拒绝)。通常需要运维干预。 |
unexpected_error |
准备或写入批次时捕获的任何其他异常。 |
shutdown_timeout |
有界关闭或关闭超时时队列中仍有行。 |
shutdown_cancelled |
当关闭被宿主取消时(例如被外部关闭超时)队列中仍有行。 |
offset_conflict |
在 exactly_once_delivery 模式下,已提交流拒绝了偏移量或替换流不可用。 |
setup_unavailable |
因插件设置失败或仍处于重试退避中而无法接收行。 |
shutdown_race |
回调在关闭正在开始或进行中时尝试接收行。 |
stale_loop |
排队的行属于已经关闭且无法再排空的事件循环。 |
formatter_failed |
自定义格式化器失败或返回了不支持的类型。行仍以 [FORMATTER_FAILED] 写入;这是事件计数,不是丢弃行计数。 |
content_parse_failed |
内容解析失败。行仍以 [CONTENT_PARSE_FAILED] 写入;这是事件计数,不是丢弃行计数。 |
丢弃原因(Java,v1.7.0+):
| 原因 | 原因说明 |
|---|---|
queue_full |
内存批处理队列溢出。增加 BigQueryLoggerConfig 上的 queueMaxSize,提高 batchSize,或扩展消费者端。 |
append_error |
批次准备或追因除 AppendSerializationError 以外的原因失败,包括超时、耗尽或不可重试的写入以及意外转换失败。 |
serialization_error |
行无法为写入流序列化(通常是模式/类型不匹配)。检查日志中的问题字段。 |
after_close |
行到达了已关闭的每次调用处理器。 |
shutdown_timeout |
有界最终排空过期时队列中仍有行。 |
writer_permit_exhausted |
实时写入器安全帽已耗尽,通常在 Storage Write 中断或延迟清理期间。 |
writer_create_error |
StreamWriter 构造或处理器启动失败。 |
late_after_finalize |
异步工作在其调用被终结后或插件关闭期间完成。 |
读取计数:
# 插件启动以来的 {reason: count} 快照。
stats = plugin.get_drop_stats()
# 示例: {"queue_full": 12, "retry_exhausted": 0,
#           "formatter_failed": 1, ...}

loss_reasons = {
    "queue_full", "arrow_prep_failed", "retry_exhausted",
    "non_retryable", "unexpected_error", "shutdown_timeout",
    "shutdown_cancelled", "offset_conflict", "setup_unavailable",
    "shutdown_race", "stale_loop",
}
total_rows_lost = sum(stats.get(reason, 0) for reason in loss_reasons)
// 插件启动以来的 {drop_reason: count} 快照。
ImmutableMap<String, Long> stats = plugin.getDropStats();
// 示例: {queue_full=12, append_error=0, serialization_error=0,
//           after_close=0, shutdown_timeout=0, writer_permit_exhausted=0,
//           writer_create_error=0, late_after_finalize=0}

long totalDropped = stats.values().stream().mapToLong(Long::longValue).sum();
导出到你的监控系统:定期轮询并发送差值:
import asyncio

async def export_loop(plugin):
    last = {}
    while True:
        current = plugin.get_drop_stats()
        for reason, count in current.items():
            delta = count - last.get(reason, 0)
            if delta:
                # 例如 metric_client.write_point(
                #         metric="bqaa_dropped_events",
                #         labels={"reason": reason}, value=delta)
                ...
        last = current
        await asyncio.sleep(60)
对每个非零原因发出告警。大多数原因意味着行在到达 BigQuery 之前就已丢失。而 formatter_failed 和 content_parse_failed 原因则表示行已着陆但内容为哨兵值,因此应将它们作为隐私或数据质量事件告警。持续的 queue_full、retry_exhausted、non_retryable 或 offset_conflict 计数通常表示吞吐量、交付或 Storage Write 健康问题。在 Java 中,类似的写入错误桶是 append_error。
多进程与 fork 安全性
Python 插件具有 fork 感知能力:它在加载 gRPC C-core 库之前设置 GRPC_ENABLE_FORK_SUPPORT=1,并注册一个 os.register_at_fork 处理器来重置子进程中继承的运行时状态(gRPC 通道、写入流、事件循环)。这意味着插件可以在 os.fork() 后存活,而不会泄漏文件描述符或在父进程的连接上发送数据。
但是,对于生产部署,spawn 是推荐的多进程启动方法。fork 会复制父进程的地址空间,包括任何正在进行的 gRPC 状态,而 fork 后的重置会增加每个子进程首次写入的延迟。使用 spawn,每个工作进程都会干净地初始化插件。
对于 Gunicorn 部署:
- 优先使用
--preload配合惰性插件初始化(插件会延迟设置直到第一个事件被记录),或者 - 在
post_fork钩子中初始化插件,以便每个工作进程获得自己的客户端。
Note
Fork 安全机制仅重置运行时状态。它不会重放在 fork 时已在父进程中排队但尚未刷新的事件。如果需要保证交付,请在 fork 前调用 await plugin.flush()。
消费记录数据的其他方式
BigQuery 智能体分析 SDK
BigQuery 智能体分析 SDK 提供了一种以编程方式消费和分析插件记录的数据的方式。使用 SDK 进行:
- 智能体评估:将智能体运行结果与预期结果进行对比
- 黄金轨迹匹配:验证智能体执行路径是否与批准的序列匹配
- 追踪可视化:从记录的 spans 重建和可视化智能体执行流
构建仪表板
使用托管的 Looker Studio 模板、现成的 Looker Block 或基于示例 Notebook 构建的你自己的仪表板来可视化你的智能体性能数据。
Looker Studio 模板
BigQuery Agent Analytics 仪表板设置页面是一种快速入门方式。输入你的事件表的完全限定 ID(project.dataset.table),它会构建一个 Looker Studio 链接,该链接会为你创建已发布模板的私有副本,其中包含预构建的报告页面,直接查询基础表,无需生成视图和数据流水线。设置页面说明它没有后端且在客户端构建链接;在输入表 ID 之前请检查其源代码。
副本使用所有者凭据创建。在将数据源切换为查看者凭据之前,请保持报告私有,这样每个查看者使用自己的访问权限查询 BigQuery,并在共享前使用仅查看者账号验证切换。
Looker Block
BigQuery 智能体分析 Looker Block 提供了一个开箱即用的仪表板,用于监控、调试和优化你的智能体,涵盖交互、工具使用、LLM 性能和成本占用等洞察。它展示:
- 聚合指标:Token 消耗、用户参与度和工具执行量。
- 系统健康:P50-P99 延迟分布和工具失败追踪,帮助你定位瓶颈。
- 交互式下钻分析:点击指标即可打开上下文感知的可视化视图,用于根因分析。
该 Block 使用 Native Derived Table 架构,直接解析记录的 JSON 负载,因此无需额外的数据流水线。要开始使用,请从 Looker Marketplace 免费安装,并将其指向你的 BigQuery 项目 ID、数据集名称和基础表名。
基于 Notebook 的自定义仪表板
BigQuery 智能体分析 SDK 包含一个示例 Jupyter Notebook,演示了如何查询和可视化智能体的性能数据。你可以将其作为起点,构建针对你的 BigQuery 智能体分析数据集量身定制的自定义仪表板。你还可以使用 Colab Data Apps 将 Notebook 发布为交互式仪表板。
反馈
我们欢迎你对 BigQuery 智能体分析插件提供反馈。如果你有任何疑问、建议或遇到任何问题,请通过 bqaa-feedback@google.com 联系团队。